“在 Postgres 中做分析”究竟意味着什么?

当今数据库领域很少有方向比“扩展 Postgres 以支持分析查询”更炙手可热了。这其实也算不上什么全新的课题——在过去十年间,业界已经有过许多次尝试:
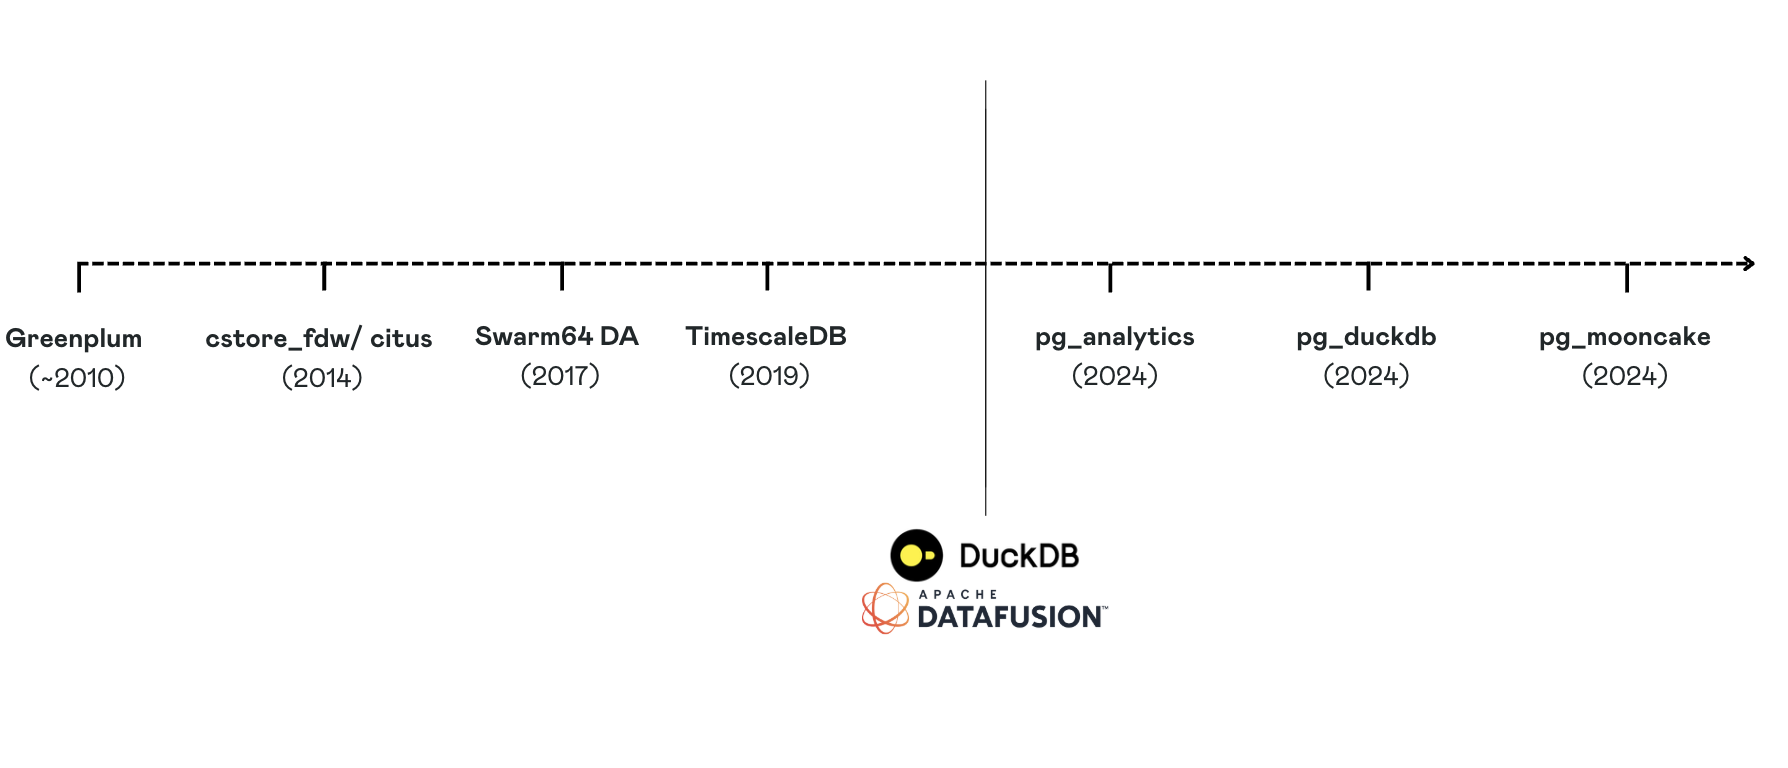
以下是我与大量客户交流后的核心总结——“Postgres 分析”对用户而言究竟意味着什么?以及为什么尽管我们在 pg_mooncake 第一阶段取得了一定成果,这个领域的终极难题在很长时间里依然悬而未决?
Level 0:直接在现有 Postgres 堆表上跑分析查询
只要配合合理的索引、统计信息、查询调优与物化视图,原生 Postgres 能够支撑的分析规模其实远超许多人的想象——很多团队在这件事上过度焦虑了。
然而,随着数据量与查询复杂度的持续增长,这套体系终究会触及天花板:过多的索引严重拖慢写入吞吐,物化视图刷新跟不上数据变化,某些大宽表聚合查询慢到无法忍受。
最终,你不可避免地会走到那个临界点:你必须把数据存成列式格式(Columnar Format)。
Level 1:我希望用 psql 直接查询外部列存数据
这一诉求在产品工程师中极具共鸣,因为它能大幅简化技术栈:开发者可以继续使用熟悉的客户端与已经配好的 ORM,还能在 Postgres 内部将分析表与业务表直接关联(JOIN)。这一层主要有两大流派:
1. pg_duckdb(在 Postgres 进程内嵌入 DuckDB)
利用内嵌的 DuckDB 向量化引擎直接查询外部列存文件(Parquet、CSV 等),并将结果流式返回给 Postgres。
2. Postgres FDW(例如 ClickHouse FDW)
从 Postgres 发起对 ClickHouse 表的查询,但查询计算本身在外部 ClickHouse 集群中执行。
无论哪种方式,查询都由向量化引擎执行,核心区别仅在于分析计算发生在你的 Postgres 实例内部还是外部计算集群上。但这两者都有一个隐含前提:你的数据已经以列存格式(如 Parquet 文件或 ClickHouse 表)存在了。
剧透一下:现实中你的数据并没有。
Level 2:我希望直接用 Postgres 写入并管理列存数据
与其搭建一套繁琐的 ETL 工具并引入一个独立的专用分析数据库作为终点,我只希望一切都在 Postgres 里搞定。
这正是我们在 pg_mooncake v0.1 中通过引入原生列存表所解决的问题:你可以像操作普通 Postgres 表一样,在列存表上创建并执行事务性的写入、删除与更新,而查询则由 DuckDB 极速执行。CMU Andy Pavlo 教授在 2024 数据库年度回顾中也重点提到了我们的这一创新。
这一思路与 Crunchy Data Warehouse 类似:两者都采用开放数据格式(Iceberg、Delta Lake、Parquet)作为底层列式存储,在避免任何数据供应商锁定的同时提供顶尖性能(ClickBench 全球前十)。
我们对 pg_mooncake 的首个正式版本(v0.1)非常满意。但很快我们发现,这还远远不够。
Level 3:我需要列存表与我的 Postgres 业务堆表保持实时同步
这里的真实用户故事是:“我的线上应用每秒都在发生各种 INSERT、UPDATE 和 DELETE,而我需要在最新鲜的数据上直接提供面向用户的实时分析。” 这种需求在应用内嵌分析(User-Facing Analytics)场景中比比皆是。目前业界主要有两条路线:
1. 在 Postgres 里造一个无所不能的“全功能事务型列存表”。
让一张列存表同时完美支持高并发 ACID 事务、二级索引、频繁更新与删除、预编译语句、触发器以及任意形态的查询——听起来像魔法,但在理论上是可行的。
当年在 SingleStore,我们花了整整十年时间打造了一套以列存作为单一事实来源(Source of Truth)的 HTAP 数据库。但残酷的现实是:即便投入了十年心血,它在纯正 OLTP 场景下依然不够完美。
我们最初也曾设想让 pg_mooncake 的列存表在 Postgres 里走同样的路,但很快就意识到:以扩展形式重造整套 OLTP 能力无异于同 Postgres 自身正面竞争——Postgres 原生堆表经过三十余年的千锤百炼,围绕它构建的特性与扩展生态实在太强大了(参见我们在 Hacker News 上的深度讨论)。
2. 将 Postgres 表通过 CDC 复制到外部专用分析系统。
典型代表如 ClickPipes + ClickHouse。
Postgres 在 WAL 层面提供了极其稳健高效的逻辑复制(CDC)机制。对于纯追加(Append-Only)场景,ClickHouse 可以通过内存缓冲并定期刷盘来轻松应对。
但一旦遇到高并发的 UPDATE 与 DELETE,问题就棘手了:ClickHouse 会在底层存储同一行数据的多个历史版本(或使用 ReplacingMergeTree),并把后台合并前的去重逻辑(如 FINAL 查询开销或自定义去重 SQL)甩给业务开发者自己处理。祝你好运。
你真正需要的,是一个能跟上 Postgres OLTP 高频更新的实时列存镜像引擎
仔细想想,这是一个近乎疯狂的工程需求:底层是磁盘或对象存储上一系列不可变(Immutable)的开放格式 Parquet/Iceberg 文件,顶层却要实时吸收高并发 OLTP 堆表的增删改流,并且还要在 Postgres 内部直接管理与强一致查询!
而这,正是我们在 pg_mooncake v0.2 / v0.3 中通过 Moonlink 实时存储引擎彻底攻克的核心难题。🥮⭐