系统架构
深入解析 pg_mooncake (v0.3.0)、pg_duckdb (1.2.0)、duckdb_mooncake (v0.0.2) 与 moonlink (v0.0.1) 如何协同在 PostgreSQL 内实现实时列式分析。
pg_mooncake(v0.3.0)在单个 PostgreSQL 实例内部深度融合了三个核心组件:
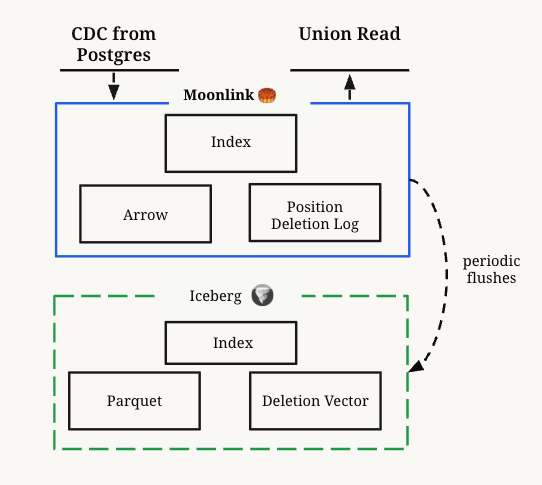
pg_duckdb(v1.2.0):在 PostgreSQL 进程内嵌入 DuckDBv2.0.0向量化分析执行引擎,并将涉及非堆表访问方法的分析查询路由至 DuckDB 执行。moonlink(v0.0.1):内嵌于pg_mooncake后台工作进程中的 Rust 实时列存引擎,负责消费 PostgreSQL 逻辑复制流、维护内存 Apache Arrow 写缓冲区与 Roaring Bitmap 删除向量、刷写 Parquet 数据文件,并生成 Apache Iceberg v2 表元数据。duckdb_mooncake(v0.0.2):随pg_mooncake打包至本地扩展目录(mooncake.extension_repository)并自动加载的 DuckDB 2.0 C++/Rust 存储扩展。它通过本地 Unix 域套接字 RPC(pg_mooncake/moonlink.sock)与 Moonlink 通信,融合扫描磁盘 Parquet 文件与内存 Arrow 批次。
三者共同向 PostgreSQL 暴露了原生的 USING mooncake 表访问方法(Table Access Method),并通过 CALL mooncake.create_table(dst, src) 进行统一管理。
pg_mooncake 0.3.0 组件版本矩阵
| 组件名称 | 版本 / 标签 | 锁定提交 (versions.json) |
核心职责 |
|---|---|---|---|
pg_mooncake |
v0.3.0 |
1a9cbfd65be9a6486d020120acb49ef0c6800d68 |
PostgreSQL 扩展(基于 pgrx 0.19.3)、SQL 存储过程、USING mooncake TAM 与后台工作进程管理 |
moonlink |
v0.0.1 |
b298ef7444890e3c8af5544e350232518bcfd8e5 |
内嵌式 Rust CDC 实时摄取引擎、Arrow 写缓冲、删除向量与 Iceberg v2 快照写入器 |
duckdb_mooncake |
v0.0.2 |
49765a369ad88986916ce53c969ed2ce4ba66fac |
DuckDB 2.0 存储扩展(mooncake.duckdb_extension),负责扫描 Moonlink 表与 Parquet 统计剪枝 |
pg_duckdb |
v1.2.0 |
8756099e267c47f0b86c24de4cf995327f1f4279 |
PostgreSQL 内嵌 DuckDB 执行桥接扩展(由扩展安装 SQL 版本守卫严格校验) |
duckdb |
v2.0.0 |
d54cbbe3df17e8e5ce68312f483b4155836112aa |
底层 C++ 向量化分析查询执行引擎 |
写入路径(Write Path)
在 pg_mooncake 中,用户不直接向 USING mooncake 列存表执行写入,而是继续向原有的 PostgreSQL 行存表(普通堆表或分区表)写入数据:
- 初始全量拷贝与复制槽创建:执行
CALL mooncake.create_table('dst', 'src')时,pg_mooncake会自动完成以下步骤:- 读取源表
src的列定义,创建采用USING mooncake访问方法的目标镜像表dst。 - 如果源表没有主键,自动将其设置为
REPLICA IDENTITY FULL(在v0.3.0中,若源表为分区表,还会自动遍历并为所有现有叶子分区设置REPLICA IDENTITY FULL)。 - 创建 PostgreSQL 逻辑发布(Publication)与逻辑复制槽(
pgoutput),将源表存量数据拷贝至 Moonlink,并记录初始一致性 WAL LSN。
- 读取源表
- 持续逻辑复制流:后台工作进程(
mooncake_bgworker)持续从逻辑复制槽读取增量 WAL 变更(INSERT、UPDATE、DELETE)并写入moonlink。 - 内存 Arrow 写缓冲 + 删除向量(Deletion Vectors):
- 插入(INSERT):追加写入内存中的 Apache Arrow 写缓冲区(默认阈值
32 MB),无需在每次事务提交时生成微小 Parquet 文件即可让新数据立即可查。 - 删除(DELETE):将目标行位置记录到 Roaring Bitmap 删除向量中,避免每次删除都重写整个 Parquet 数据文件。
- 更新(UPDATE):原子性地组合为“在删除向量中标记旧行 + 向 Arrow 写缓冲区追加新行”。
- 插入(INSERT):追加写入内存中的 Apache Arrow 写缓冲区(默认阈值
- 后台合并与 Parquet / Iceberg 刷盘:当内存写缓冲达到阈值,或显式调用
CALL mooncake.create_snapshot('dst')/CALL mooncake.optimize_table('dst', 'full')时,Moonlink 将内存 Arrow 批次刷写为压缩的 Parquet 文件,并更新 Apache Iceberg v2 元数据。
读取路径(Read Path)
当执行涉及 USING mooncake 列存镜像表的 SELECT 查询时:
- 通过
pg_duckdb路由查询:PostgreSQL 查询规划器识别出已通过RegisterDuckdbTableAm("mooncake")注册的mooncake表访问方法,将分析算子下推至进程内的 DuckDB 2.0 引擎。 - 自动挂载 DuckDB 扩展:在会话首次扫描列存表时,
pg_mooncake自动设置SET extension_directory = '<mooncake.extension_repository>',加载mooncakeDuckDB 扩展(duckdb_mooncake v0.0.2),并执行ATTACH '' AS mooncake (TYPE mooncake, METADATA '<pgdata>/pg_mooncake')。 - LSN 同步屏障(Read-Your-Own-Writes):开始表扫描前,
duckdb_mooncake获取当前 PostgreSQL 的 WAL 写入位点 LSN,并通过 RPC(scan_table_begin)通知 Moonlink 等待逻辑复制流推进至该 LSN,从而保证事务级强一致性读取。 - Arrow + Parquet 混合扫描与分段跳过:
- Moonlink 返回当前快照下有效的 Parquet 文件列表、删除向量位图以及内存 Arrow 缓冲区指针。
duckdb_mooncake通过 DuckDB 2.0 导出的多文件读取器接口读取 Parquet 列的最小/最大值统计信息,自动跳过不满足过滤条件的文件与行组(Segment Elimination),应用删除向量过滤后将结果流式返回给 PostgreSQL。
存储布局
默认情况下(mooncake.default_bucket = ''),Moonlink 将表元数据、删除向量与 Parquet 数据文件存储在 PostgreSQL 数据目录下的 $PGDATA/pg_mooncake/ 中。
当将 mooncake.default_bucket 配置为 s3:// 或 r2:// 路径(并在 duckdb.secrets 中配置对象存储凭据)时,Moonlink 会将 Parquet 数据文件与 Apache Iceberg v2 元数据(metadata/*.metadata.json 及 Avro 清单文件)直接写入对象存储。你可以随时通过以下 SQL 查看每张镜像表的 LSN 同步进度与 Iceberg 仓库路径: