深入了解 pg_mooncake、pg_duckdb、duckdb_mooncake 与 moonlink 如何协同完成写入、查询与 Iceberg 快照生成。
这是本节的多页打印视图。 .
欢迎使用 pg_mooncake
pg_mooncake (v0.3.0) 概览:在 PostgreSQL 内提供实时列存镜像表、Moonlink CDC 逻辑复制摄取、DuckDB 2.0 向量化执行与 Apache Iceberg v2 湖仓表。
pg_mooncake 是一款 PostgreSQL 扩展,能够在数据库内部直接提供实时列存镜像表(USING mooncake)、基于 DuckDB 2.0 的向量化分析执行引擎(通过 pg_duckdb 与 duckdb_mooncake),以及开放的 Apache Iceberg v2 湖仓存储(由 moonlink 驱动)。
搭载 pg_mooncake 的 PostgreSQL 在 ClickBench 分析基准测试中名列前茅,同时完全保留原有的 PostgreSQL 事务写入路径。该扩展套件原由 Mooncake Labs 开发,现由 PGSTY 社区维护(包含 pg_mooncake v0.3.0、duckdb_mooncake v0.0.2 与 moonlink v0.0.1),全面支持 PostgreSQL 14–18。
PGSTY 维护的扩展套件(
v0.3.0)pgsty/pg_mooncake(v0.3.0,MIT许可证):PostgreSQL 核心扩展,提供USING mooncake表访问方法、mooncake.*SQL 存储过程以及内嵌的 Moonlink 后台工作进程(基于pgrx 0.19.3)。pgsty/moonlink(v0.0.1,BSL-1.1附带pg_mooncake链接与分发豁免):Rust 实时列存摄取引擎,通过 PostgreSQL 逻辑复制接收 WAL 变更,维护内存 Arrow 写缓冲区、Roaring Bitmap 删除向量以及 Apache Iceberg v2 / Parquet 文件。pgsty/duckdb_mooncake(v0.0.2,MIT许可证):随pg_mooncake一同打包的 DuckDB 2.0 存储扩展,支持扫描 Moonlink 表并利用多文件 Parquet 统计信息执行高效分段跳过。
传统方案的痛点
PostgreSQL 是极其优秀的事务型(OLTP)数据库,但其面向行的堆表存储与逐行执行器并非为大规模分析扫描(OLAP)而设计。长期以来,PostgreSQL 用户往往面临两难选择:
- 引入外部独立分析引擎(ClickHouse、Snowflake、BigQuery) 需要额外部署并维护脆弱的 CDC 数据管道(Debezium + Kafka),被迫重构数据模型,承受最终一致性延迟,且无法在单条 SQL 中直接关联实时业务表与历史分析表。
- 使用缺乏向量化引擎或高频 CDC 能力的库内列存扩展
传统库内列存方案要么缺乏现代向量化执行引擎,要么在面对高频 OLTP
INSERT、UPDATE、DELETE时产生海量微小的 Parquet 文件(小文件风暴),导致读写性能迅速劣化。
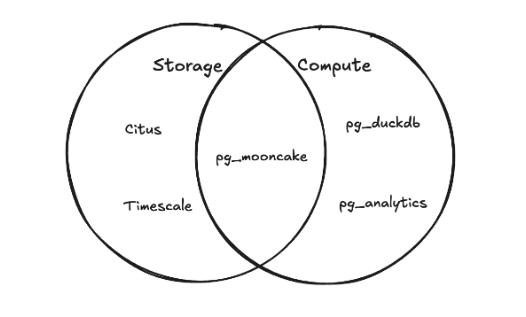
pg_mooncake 的解决之道
从 v0.2 架构重设计并在 PGSTY 维护的 v0.3.0 版本中进一步完善,pg_mooncake 采用了**实时列存镜像(Columnstore Mirror)**架构:
- 写入行存表,查询列存表:业务应用继续向标准的 PostgreSQL
trades行存表执行INSERT、UPDATE、DELETE,享受完整的 ACID 事务与行存索引性能。 - 基于 Moonlink 的亚秒级逻辑复制:
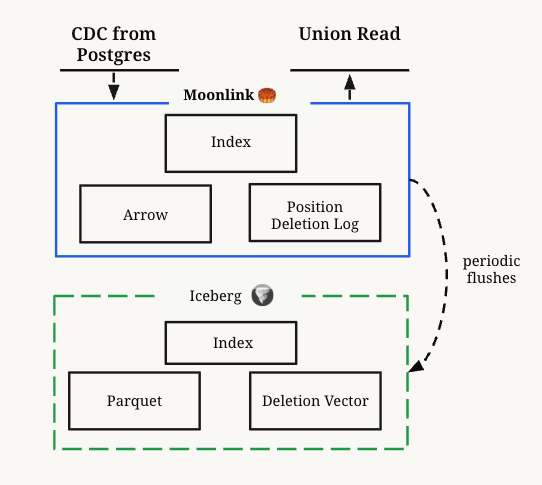
pg_mooncake后台工作进程将 WAL 变更实时推送至moonlink;最新写入在内存中缓冲为 Apache Arrow 列存批次,UPDATE与DELETE通过 Roaring Bitmap 删除向量就地标记,并在后台异步刷盘与合并为 Parquet 文件。 - DuckDB 2.0 向量化查询与 LSN 屏障:针对
trades_analytics的分析查询由pg_duckdb 1.2.0与duckdb_mooncake v0.0.2接管,在等待目标 WAL LSN 同步屏障后,零拷贝融合扫描内存 Arrow 缓冲与磁盘 Parquet 文件。 - 开放 Apache Iceberg v2 湖仓表:执行
CALL mooncake.create_snapshot('trades_analytics')即可在本地磁盘、AWS S3 或 Cloudflare R2 上生成标准 Apache Iceberg v2 元数据快照,无需任何 ETL 即可供 Spark、Snowflake、DuckDB 或 PyIceberg 直接读取。
本章内容导航
深入剖析 Moonlink(v0.0.1)的内存 Arrow 写缓冲、删除向量机制,以及独立 HTTP/RPC 服务部署方式。
了解 duckdb_mooncake v0.0.2 如何适配 DuckDB 2.0 与 pg_duckdb 1.2.0,实现多文件 Parquet 统计信息剪枝。
对比早期 v0.1 Delta Lake(USING columnstore)架构、v0.2 Moonlink 镜像架构以及 PGSTY v0.3.0 的工程改进。
1 - 系统架构
深入解析 pg_mooncake (v0.3.0)、pg_duckdb (1.2.0)、duckdb_mooncake (v0.0.2) 与 moonlink (v0.0.1) 如何协同在 PostgreSQL 内实现实时列式分析。
pg_mooncake(v0.3.0)在单个 PostgreSQL 实例内部深度融合了三个核心组件:
pg_duckdb(v1.2.0):在 PostgreSQL 进程内嵌入 DuckDBv2.0.0向量化分析执行引擎,并将涉及非堆表访问方法的分析查询路由至 DuckDB 执行。moonlink(v0.0.1):内嵌于pg_mooncake后台工作进程中的 Rust 实时列存引擎,负责消费 PostgreSQL 逻辑复制流、维护内存 Apache Arrow 写缓冲区与 Roaring Bitmap 删除向量、刷写 Parquet 数据文件,并生成 Apache Iceberg v2 表元数据。duckdb_mooncake(v0.0.2):随pg_mooncake打包至本地扩展目录(mooncake.extension_repository)并自动加载的 DuckDB 2.0 C++/Rust 存储扩展。它通过本地 Unix 域套接字 RPC(pg_mooncake/moonlink.sock)与 Moonlink 通信,融合扫描磁盘 Parquet 文件与内存 Arrow 批次。
三者共同向 PostgreSQL 暴露了原生的 USING mooncake 表访问方法(Table Access Method),并通过 CALL mooncake.create_table(dst, src) 进行统一管理。
pg_mooncake 0.3.0 组件版本矩阵
| 组件名称 | 版本 / 标签 | 锁定提交 (versions.json) |
核心职责 |
|---|---|---|---|
pg_mooncake |
v0.3.0 |
1a9cbfd65be9a6486d020120acb49ef0c6800d68 |
PostgreSQL 扩展(基于 pgrx 0.19.3)、SQL 存储过程、USING mooncake TAM 与后台工作进程管理 |
moonlink |
v0.0.1 |
b298ef7444890e3c8af5544e350232518bcfd8e5 |
内嵌式 Rust CDC 实时摄取引擎、Arrow 写缓冲、删除向量与 Iceberg v2 快照写入器 |
duckdb_mooncake |
v0.0.2 |
49765a369ad88986916ce53c969ed2ce4ba66fac |
DuckDB 2.0 存储扩展(mooncake.duckdb_extension),负责扫描 Moonlink 表与 Parquet 统计剪枝 |
pg_duckdb |
v1.2.0 |
8756099e267c47f0b86c24de4cf995327f1f4279 |
PostgreSQL 内嵌 DuckDB 执行桥接扩展(由扩展安装 SQL 版本守卫严格校验) |
duckdb |
v2.0.0 |
d54cbbe3df17e8e5ce68312f483b4155836112aa |
底层 C++ 向量化分析查询执行引擎 |
写入路径(Write Path)
在 pg_mooncake 中,用户不直接向 USING mooncake 列存表执行写入,而是继续向原有的 PostgreSQL 行存表(普通堆表或分区表)写入数据:
- 初始全量拷贝与复制槽创建:执行
CALL mooncake.create_table('dst', 'src')时,pg_mooncake会自动完成以下步骤:- 读取源表
src的列定义,创建采用USING mooncake访问方法的目标镜像表dst。 - 如果源表没有主键,自动将其设置为
REPLICA IDENTITY FULL(在v0.3.0中,若源表为分区表,还会自动遍历并为所有现有叶子分区设置REPLICA IDENTITY FULL)。 - 创建 PostgreSQL 逻辑发布(Publication)与逻辑复制槽(
pgoutput),将源表存量数据拷贝至 Moonlink,并记录初始一致性 WAL LSN。
- 读取源表
- 持续逻辑复制流:后台工作进程(
mooncake_bgworker)持续从逻辑复制槽读取增量 WAL 变更(INSERT、UPDATE、DELETE)并写入moonlink。 - 内存 Arrow 写缓冲 + 删除向量(Deletion Vectors):
- 插入(INSERT):追加写入内存中的 Apache Arrow 写缓冲区(默认阈值
32 MB),无需在每次事务提交时生成微小 Parquet 文件即可让新数据立即可查。 - 删除(DELETE):将目标行位置记录到 Roaring Bitmap 删除向量中,避免每次删除都重写整个 Parquet 数据文件。
- 更新(UPDATE):原子性地组合为“在删除向量中标记旧行 + 向 Arrow 写缓冲区追加新行”。
- 插入(INSERT):追加写入内存中的 Apache Arrow 写缓冲区(默认阈值
- 后台合并与 Parquet / Iceberg 刷盘:当内存写缓冲达到阈值,或显式调用
CALL mooncake.create_snapshot('dst')/CALL mooncake.optimize_table('dst', 'full')时,Moonlink 将内存 Arrow 批次刷写为压缩的 Parquet 文件,并更新 Apache Iceberg v2 元数据。
读取路径(Read Path)
当执行涉及 USING mooncake 列存镜像表的 SELECT 查询时:
- 通过
pg_duckdb路由查询:PostgreSQL 查询规划器识别出已通过RegisterDuckdbTableAm("mooncake")注册的mooncake表访问方法,将分析算子下推至进程内的 DuckDB 2.0 引擎。 - 自动挂载 DuckDB 扩展:在会话首次扫描列存表时,
pg_mooncake自动设置SET extension_directory = '<mooncake.extension_repository>',加载mooncakeDuckDB 扩展(duckdb_mooncake v0.0.2),并执行ATTACH '' AS mooncake (TYPE mooncake, METADATA '<pgdata>/pg_mooncake')。 - LSN 同步屏障(Read-Your-Own-Writes):开始表扫描前,
duckdb_mooncake获取当前 PostgreSQL 的 WAL 写入位点 LSN,并通过 RPC(scan_table_begin)通知 Moonlink 等待逻辑复制流推进至该 LSN,从而保证事务级强一致性读取。 - Arrow + Parquet 混合扫描与分段跳过:
- Moonlink 返回当前快照下有效的 Parquet 文件列表、删除向量位图以及内存 Arrow 缓冲区指针。
duckdb_mooncake通过 DuckDB 2.0 导出的多文件读取器接口读取 Parquet 列的最小/最大值统计信息,自动跳过不满足过滤条件的文件与行组(Segment Elimination),应用删除向量过滤后将结果流式返回给 PostgreSQL。
存储布局
默认情况下(mooncake.default_bucket = ''),Moonlink 将表元数据、删除向量与 Parquet 数据文件存储在 PostgreSQL 数据目录下的 $PGDATA/pg_mooncake/ 中。
当将 mooncake.default_bucket 配置为 s3:// 或 r2:// 路径(并在 duckdb.secrets 中配置对象存储凭据)时,Moonlink 会将 Parquet 数据文件与 Apache Iceberg v2 元数据(metadata/*.metadata.json 及 Avro 清单文件)直接写入对象存储。你可以随时通过以下 SQL 查看每张镜像表的 LSN 同步进度与 Iceberg 仓库路径:
2 - Moonlink 实时摄取引擎
深入剖析 Moonlink (v0.0.1):实时 CDC 数据摄取、Arrow 内存写缓冲、Roaring 删除向量、LSN 快照屏障与独立 HTTP/RPC 服务部署。
Moonlink(pgsty/moonlink,当前正式版本 v0.0.1)是一个使用 Rust 编写的高性能实时列存摄取库与独立服务,旨在无需引入 Apache Spark 或 Kafka 的前提下,面向在线业务系统与事件流实时构建并维护 Apache Iceberg v2 与 Delta Lake 表。
在 pg_mooncake 内部,Moonlink 作为内嵌的 PostgreSQL 后台工作进程(mooncake_bgworker)运行,并通过本地 Unix 域套接字($PGDATA/pg_mooncake/moonlink.sock)提供低延迟 RPC 通信;同时,它也可以独立编译并部署为对外提供 HTTP REST 与 gRPC 接口的摄取服务(moonlink_service)。
开源许可证说明(
BSL-1.1 附带 pg_mooncake 链接与分发豁免)核心 moonlink 服务端引擎采用 BSL-1.1 许可证(将于 2029-05-05 自动转换为 Apache-2.0),并附带明确的 PG_MOONCAKE LINKING & DISTRIBUTION EXCEPTION(链接与分发豁免条款),允许在作为 pg_mooncake 的一部分嵌入或分发时不受限制地链接、修改与再分发。其协议与客户端库(moonlink_rpc、moonlink_proto、moonlink_error、moonlink_table_metadata)均采用 MIT 许可证。完整条款请参阅许可证说明。
核心设计原理
传统数据湖写入器在**数据新鲜度(Freshness)与查询性能(Query Performance)**之间面临天然矛盾:如果每次单行写入都立即刷盘,会产生数以万计的微小 Parquet 文件;如果攒批 5–15 分钟再写入,又无法满足实时分析的延迟要求。
Moonlink 通过多级存储架构彻底消除了这一矛盾:
- 内存 Apache Arrow 写缓冲区:实时流入的
INSERT与UPDATE新行首先追加至内存中的 ArrowRecordBatch写缓冲区(write_buffer_size,默认32 MB)。读取端(duckdb_mooncake)无需等待刷盘即可通过零拷贝 Arrow 接口直接扫描最新数据。 - 基于 Roaring Bitmap 的删除向量(Deletion Vectors):面对高频
UPDATE与DELETE,Moonlink 无需重写已有 Parquet 文件,而是通过 B-Tree 主键索引(moonlink_btree)定位旧行偏移量,并将其记录在压缩的 Roaring Bitmap 删除向量中。 - LSN 位点追踪与非阻塞快照屏障:从 PostgreSQL WAL 摄取的每一笔事务均带有提交
lsn标记。查询在调用scan_table_begin时传入目标 LSN,仅当逻辑复制尚未追平该 LSN 时才短暂等待,确保强一致性读取。 - 后台异步合并与 Iceberg v2 元数据输出:后台合并任务自动将刷盘后的 Parquet 文件段合并为大文件、清理已标记删除的行,并在本地磁盘或 S3/R2 对象存储上生成标准 Apache Iceberg v2
metadata.json与 Avro 清单文件。
moonlink v0.0.1 的核心工程修复
在 PGSTY 发布的 moonlink v0.0.1(b298ef7444890e3c8af5544e350232518bcfd8e5)版本中,包含了以下关键工程修复:
- 修复其他表推进数据库 WAL 时
create_snapshot(lsn)挂起的问题:此前,当数据库内其他无关表发生写入导致全局 WAL LSN 推进,而目标列存镜像表没有新事务提交时,调用CALL mooncake.create_snapshot('table')会无限期等待目标表达到最新数据库 LSN。在v0.0.1中,复制流进度通知会自动推进表级安全 LSN 水位线并立即刷写已提交的旧数据,即使该表后续没有新事务提交也能正常完成快照。 - 58/58 表处理器单元测试全部通过:在 Rocky Linux 10(
aarch64)与 Ubuntu 24.04(aarch64)环境下全面验证了追加、更新、删除、回滚、文件合并与快照屏障场景。 - RustSec 依赖安全升级:升级修复了
bytes、crossbeam-epoch、h2、lz4_flex、quinn-proto、rustls、rustls-webpki、webpki-roots、time、zstd、anyhow、event-listener、lru(0.18.5)、memmap2、rand、tokio(1.51.6)、aws-lc-rs与serial_test等 20 余项安全公告。
独立服务部署(moonlink_service)
除了内嵌在 pg_mooncake 中运行外,你也可以将 moonlink_service 作为独立摄取服务器运行,通过 HTTP REST 或 gRPC 流式写入 Iceberg 表。
从源码编译 moonlink_service
独立 REST API 使用示例
独立服务默认监听 3030 端口,提供表创建、实时行写入与 Iceberg 快照生成的 JSON 接口:
使用 DuckDB 直接查询生成的 Iceberg 快照
快照生成后,任何兼容 Apache Iceberg 的计算引擎(DuckDB、Spark、Trino、Snowflake、PyIceberg)均可直接读取该表:
3 - duckdb_mooncake 与 DuckDB 2.0 集成
解析 duckdb_mooncake (v0.0.2) 如何连接 DuckDB 2.0 与 pg_duckdb 1.2.0 至 Moonlink 表、执行多文件 Parquet 统计剪枝,并通过本地扩展仓库加载。
duckdb_mooncake(pgsty/duckdb_mooncake,当前正式版本 v0.0.2,MIT 许可证)是面向 DuckDB v2.0.0 的 C++ 与 Rust FFI 存储扩展。它使 DuckDB(无论是独立运行还是通过 pg_duckdb 1.2.0 内嵌在 PostgreSQL 中)能够直接挂载 moonlink 元数据目录,并对 Moonlink 表执行高性能向量化扫描。
在 pg_mooncake 0.3.0 中的核心角色
当 pg_mooncake 在 PostgreSQL 内执行针对 USING mooncake 列存表的查询时,pg_duckdb 会将表扫描算子委托给 DuckDB 执行。pg_mooncake 在初始化 DuckDB 会话时会自动执行以下命令:
本地扩展仓库(mooncake.extension_repository)
不同于早期版本在运行时从远程社区存储桶下载扩展二进制文件,pg_mooncake 0.3.0 在编译和打包阶段即直接构建 mooncake.duckdb_extension(v0.0.2),并随 PostgreSQL 扩展一同安装至本地 DuckDB 扩展目录:
PostgreSQL 配置参数 mooncake.extension_repository 默认指向该目录(也可在 postgresql.conf 中显式指定自定义路径),配合 duckdb.allow_unsigned_extensions = true 实现完全离线、确定性、字节级一致的本地扩展加载。
v0.0.2 对 DuckDB 2.0 的关键适配
在 PGSTY 发布的 duckdb_mooncake v0.0.2(49765a369ad88986916ce53c969ed2ce4ba66fac)版本中,完成了面向 DuckDB v2.0.0(d54cbbe3df17e8e5ce68312f483b4155836112aa)与 pg_duckdb 1.2.0 的深度适配:
- 适配 DuckDB 2.0 存储与目录 API:更新了存储扩展注册、Catalog 条目查找、Arrow Schema 转换(
nanoarrow 0.7)、表函数绑定、多文件列表(Multi-File Lists)以及表过滤条件(Table Filter)下推接口。 - 改用导出的多文件 Parquet 统计信息接口:旧版代码直接依赖
ParquetReader的内部符号,而这些符号在 DuckDB 2.0 的libduckdb.so中已不再导出。duckdb_mooncake v0.0.2改用 DuckDB 2.0 公开导出的多文件读取器接口(MultiFileReader)读取 Parquet 列级最小/最大值统计信息,并通过ldd -r验证与pg_duckdb的libduckdb.so之间零未解析动态符号。 - 消除对象缓存(Object Cache)重入死锁:此前在持有对象缓存互斥锁期间构造统计信息条目,若加载 Parquet 元数据时再次访问 DuckDB 对象缓存,会导致互斥锁重入死锁。
v0.0.2改为在对象缓存互斥锁外部完成统计信息条目的构造,再原子写入缓存。 - CRoaring 与 Corrosion 构建加固:使用
Corrosion v0.5、nanoarrow 0.7与CRoaring v5.5.4(当系统缺少libroaring时执行 SHA-256 校验构建),并以--locked模式锁定moonlink_ffiRust 客户端依赖(RustSec 漏洞匹配数为0)。
在独立 DuckDB CLI 中使用
你也可以在独立的 DuckDB v2.0.0 命令行(duckdb -unsigned)中直接加载 duckdb_mooncake,用于检查或查询 Moonlink 数据目录:
4 - v0.1 与 v0.2 / v0.3 架构演进对比
全面对比 pg_mooncake v0.1(USING columnstore + Delta Lake)、v0.2(USING mooncake + Moonlink + Iceberg)与 PGSTY v0.3.0 正式版。
pg_mooncake 的技术架构经历了三个关键演进阶段:
v0.1(早期 Delta Lake 架构):引入直接通过CREATE TABLE ... USING columnstore创建的列存表,底层基于 Delta Lake 与早期pg_duckdb实现读写。v0.2(Moonlink 与 Apache Iceberg 架构重设计):废弃对列存表的直接写入,改用由moonlink逻辑复制驱动的**实时列存镜像(Columnstore Mirror)**架构(CALL mooncake.create_table(dst, src)+USING mooncake),引入内存 Arrow 写缓冲、Roaring 删除向量与 Apache Iceberg v2 元数据。v0.3.0(PGSTY 社区维护正式版):将pg_mooncake升级至pgrx 0.19.3(全面支持 PostgreSQL 14–18),将duckdb_mooncake v0.0.2移植适配至pg_duckdb 1.2.0与 DuckDBv2.0.0,修复了 Moonlink(v0.0.1)在无关表推进 WAL 时的快照挂起问题与分区表复制标识设置,并修复了 20 余项 RustSec 依赖安全漏洞。
寻找
v0.1 历史版本文档?早期 v0.1 版本(USING columnstore、mooncake.create_secret、mooncake.columnstore_tables、mooncake.read_parquet)的完整文档已归档保留在 v0.1 历史文档 (Delta Lake) 中。
核心架构对比表
| 特性维度 | v0.1(早期版本) |
v0.2(Moonlink 重构版) |
v0.3.0(当前 PGSTY 正式版) |
|---|---|---|---|
| 列存表创建方式 | CREATE TABLE t (...) USING columnstore; |
CALL mooncake.create_table(dst, src); |
CALL mooncake.create_table(dst, src, src_uri, table_config); |
| 表访问方法 (TAM) | USING columnstore |
USING mooncake(只读镜像表) |
USING mooncake(只读镜像表) |
| 写入路径设计 | 直接向列存表执行 DML(每笔事务生成 1 个 Parquet 文件) | 写入标准 Postgres 行存表,通过 moonlink 逻辑复制实时同步 |
写入普通堆表或分区表,通过 moonlink v0.0.1 逻辑复制实时同步 |
| 高频小写入与更新处理 | 高频小事务下产生大量小文件,更新需重写文件 | 亚秒级内存 Arrow 写缓冲 + Roaring Bitmap 删除向量 | 亚秒级 Arrow 写缓冲 + 删除向量 + 非阻塞 LSN 快照屏障 |
| 开放湖仓格式 | Delta Lake(mooncake.columnstore_tables) |
Apache Iceberg v2(mooncake.list_tables()) |
Apache Iceberg v2(mooncake.list_tables()) |
| DuckDB 执行引擎 | DuckDB 1.1 / pg_duckdb 0.2 |
DuckDB 1.3 / pg_duckdb |
DuckDB v2.0.0 / pg_duckdb 1.2.0(duckdb_mooncake v0.0.2) |
| PostgreSQL 版本支持 | PostgreSQL 14–17(pgrx 0.12) |
PostgreSQL 14–17(pgrx 0.16.1) |
PostgreSQL 14–18(pgrx 0.19.3) |
| 分区源表支持 | 不支持 | 支持(需手动为子分区设置复制标识) | 创建镜像时自动为所有现有叶子分区设置 REPLICA IDENTITY FULL |
为什么 v0.2 / v0.3 放弃了 v0.1 的直接写入模型?
v0.1 直接写入模型的局限性
在 v0.1 中,直接向 USING columnstore 表写入数据虽然在大批量导入(单事务 100,000–1,000,000 行)时表现良好,但在真实的在线 PostgreSQL 业务负载中存在明显瓶颈:
- 不支持索引与约束:无法在
USING columnstore表上创建主键、唯一约束、外键或 B-Tree 索引。 - 小文件写放大:每一笔
INSERT或UPDATE事务都会生成一个新的 Parquet 文件,在高频 OLTP 流量下会导致文件碎片激增、查询性能快速下降。 - DuckDB 写入路径耦合:在 PostgreSQL 事务执行器内部通过 DuckDB 执行写入,带来了较高的内存开销与事务状态管理复杂度。
v0.2 与 v0.3.0 如何解决这些问题
通过将 OLTP 写入路径(标准 PostgreSQL 行存表)与分析存储计算路径(moonlink + pg_duckdb 1.2.0 + duckdb_mooncake v0.0.2)彻底解耦:
- 对在线 OLTP 业务零侵入:源业务表完整保留 PostgreSQL 的全部能力——主键、外键、B-Tree/GIN/vchord 索引、触发器与行级并发锁。
- 高吞吐增量变更摄取:
moonlink利用内存 Arrow 写缓冲与 Roaring 删除向量高效吸收高频INSERT、UPDATE、DELETE变更流,并在后台异步刷写与合并优化后的 Parquet 文件。 - 自动同步表结构变更:在源行存表上执行
ALTER TABLE ... ADD COLUMN与DROP COLUMN会自动同步至列存镜像表。 - 支持远程实例复制(
src_uri):你甚至可以在专门的分析型 PostgreSQL 实例上部署pg_mooncake,通过src_uri => 'postgresql://...'实时镜像远程生产数据库(包括 AWS RDS、Aurora、Supabase 或 Neon)中的业务表。