欢迎使用 pg_mooncake
pg_mooncake 是一款 PostgreSQL 扩展,能够在数据库内部直接提供实时列存镜像表(USING mooncake)、基于 DuckDB 2.0 的向量化分析执行引擎(通过 pg_duckdb 与 duckdb_mooncake),以及开放的 Apache Iceberg v2 湖仓存储(由 moonlink 驱动)。
搭载 pg_mooncake 的 PostgreSQL 在 ClickBench 分析基准测试中名列前茅,同时完全保留原有的 PostgreSQL 事务写入路径。该扩展套件原由 Mooncake Labs 开发,现由 PGSTY 社区维护(包含 pg_mooncake v0.3.0、duckdb_mooncake v0.0.2 与 moonlink v0.0.1),全面支持 PostgreSQL 14–18。
v0.3.0)pgsty/pg_mooncake(v0.3.0,MIT许可证):PostgreSQL 核心扩展,提供USING mooncake表访问方法、mooncake.*SQL 存储过程以及内嵌的 Moonlink 后台工作进程(基于pgrx 0.19.3)。pgsty/moonlink(v0.0.1,BSL-1.1附带pg_mooncake链接与分发豁免):Rust 实时列存摄取引擎,通过 PostgreSQL 逻辑复制接收 WAL 变更,维护内存 Arrow 写缓冲区、Roaring Bitmap 删除向量以及 Apache Iceberg v2 / Parquet 文件。pgsty/duckdb_mooncake(v0.0.2,MIT许可证):随pg_mooncake一同打包的 DuckDB 2.0 存储扩展,支持扫描 Moonlink 表并利用多文件 Parquet 统计信息执行高效分段跳过。
传统方案的痛点
PostgreSQL 是极其优秀的事务型(OLTP)数据库,但其面向行的堆表存储与逐行执行器并非为大规模分析扫描(OLAP)而设计。长期以来,PostgreSQL 用户往往面临两难选择:
- 引入外部独立分析引擎(ClickHouse、Snowflake、BigQuery) 需要额外部署并维护脆弱的 CDC 数据管道(Debezium + Kafka),被迫重构数据模型,承受最终一致性延迟,且无法在单条 SQL 中直接关联实时业务表与历史分析表。
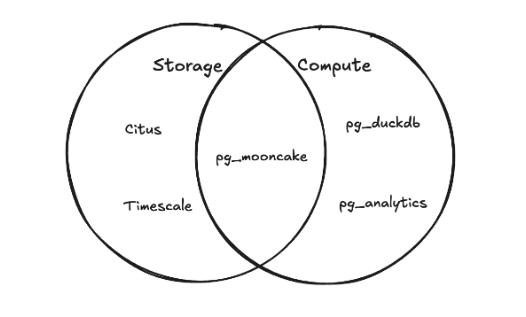
- 使用缺乏向量化引擎或高频 CDC 能力的库内列存扩展
传统库内列存方案要么缺乏现代向量化执行引擎,要么在面对高频 OLTP
INSERT、UPDATE、DELETE时产生海量微小的 Parquet 文件(小文件风暴),导致读写性能迅速劣化。
pg_mooncake 的解决之道
从 v0.2 架构重设计并在 PGSTY 维护的 v0.3.0 版本中进一步完善,pg_mooncake 采用了**实时列存镜像(Columnstore Mirror)**架构:
- 写入行存表,查询列存表:业务应用继续向标准的 PostgreSQL
trades行存表执行INSERT、UPDATE、DELETE,享受完整的 ACID 事务与行存索引性能。 - 基于 Moonlink 的亚秒级逻辑复制:
pg_mooncake后台工作进程将 WAL 变更实时推送至moonlink;最新写入在内存中缓冲为 Apache Arrow 列存批次,UPDATE与DELETE通过 Roaring Bitmap 删除向量就地标记,并在后台异步刷盘与合并为 Parquet 文件。 - DuckDB 2.0 向量化查询与 LSN 屏障:针对
trades_analytics的分析查询由pg_duckdb 1.2.0与duckdb_mooncake v0.0.2接管,在等待目标 WAL LSN 同步屏障后,零拷贝融合扫描内存 Arrow 缓冲与磁盘 Parquet 文件。 - 开放 Apache Iceberg v2 湖仓表:执行
CALL mooncake.create_snapshot('trades_analytics')即可在本地磁盘、AWS S3 或 Cloudflare R2 上生成标准 Apache Iceberg v2 元数据快照,无需任何 ETL 即可供 Spark、Snowflake、DuckDB 或 PyIceberg 直接读取。
本章内容导航
深入了解 pg_mooncake、pg_duckdb、duckdb_mooncake 与 moonlink 如何协同完成写入、查询与 Iceberg 快照生成。
深入剖析 Moonlink(v0.0.1)的内存 Arrow 写缓冲、删除向量机制,以及独立 HTTP/RPC 服务部署方式。
了解 duckdb_mooncake v0.0.2 如何适配 DuckDB 2.0 与 pg_duckdb 1.2.0,实现多文件 Parquet 统计信息剪枝。
对比早期 v0.1 Delta Lake(USING columnstore)架构、v0.2 Moonlink 镜像架构以及 PGSTY v0.3.0 的工程改进。
深入解析 pg_mooncake (v0.3.0)、pg_duckdb (1.2.0)、duckdb_mooncake (v0.0.2) 与 moonlink (v0.0.1) 如何协同在 PostgreSQL 内实现实时列式分析。
深入剖析 Moonlink (v0.0.1):实时 CDC 数据摄取、Arrow 内存写缓冲、Roaring 删除向量、LSN 快照屏障与独立 HTTP/RPC 服务部署。
解析 duckdb_mooncake (v0.0.2) 如何连接 DuckDB 2.0 与 pg_duckdb 1.2.0 至 Moonlink 表、执行多文件 Parquet 统计剪枝,并通过本地扩展仓库加载。
全面对比 pg_mooncake v0.1(USING columnstore + Delta Lake)、v0.2(USING mooncake + Moonlink + Iceberg)与 PGSTY v0.3.0 正式版。