ClickBench 基准测试证明:Postgres 是一流的分析型数据库

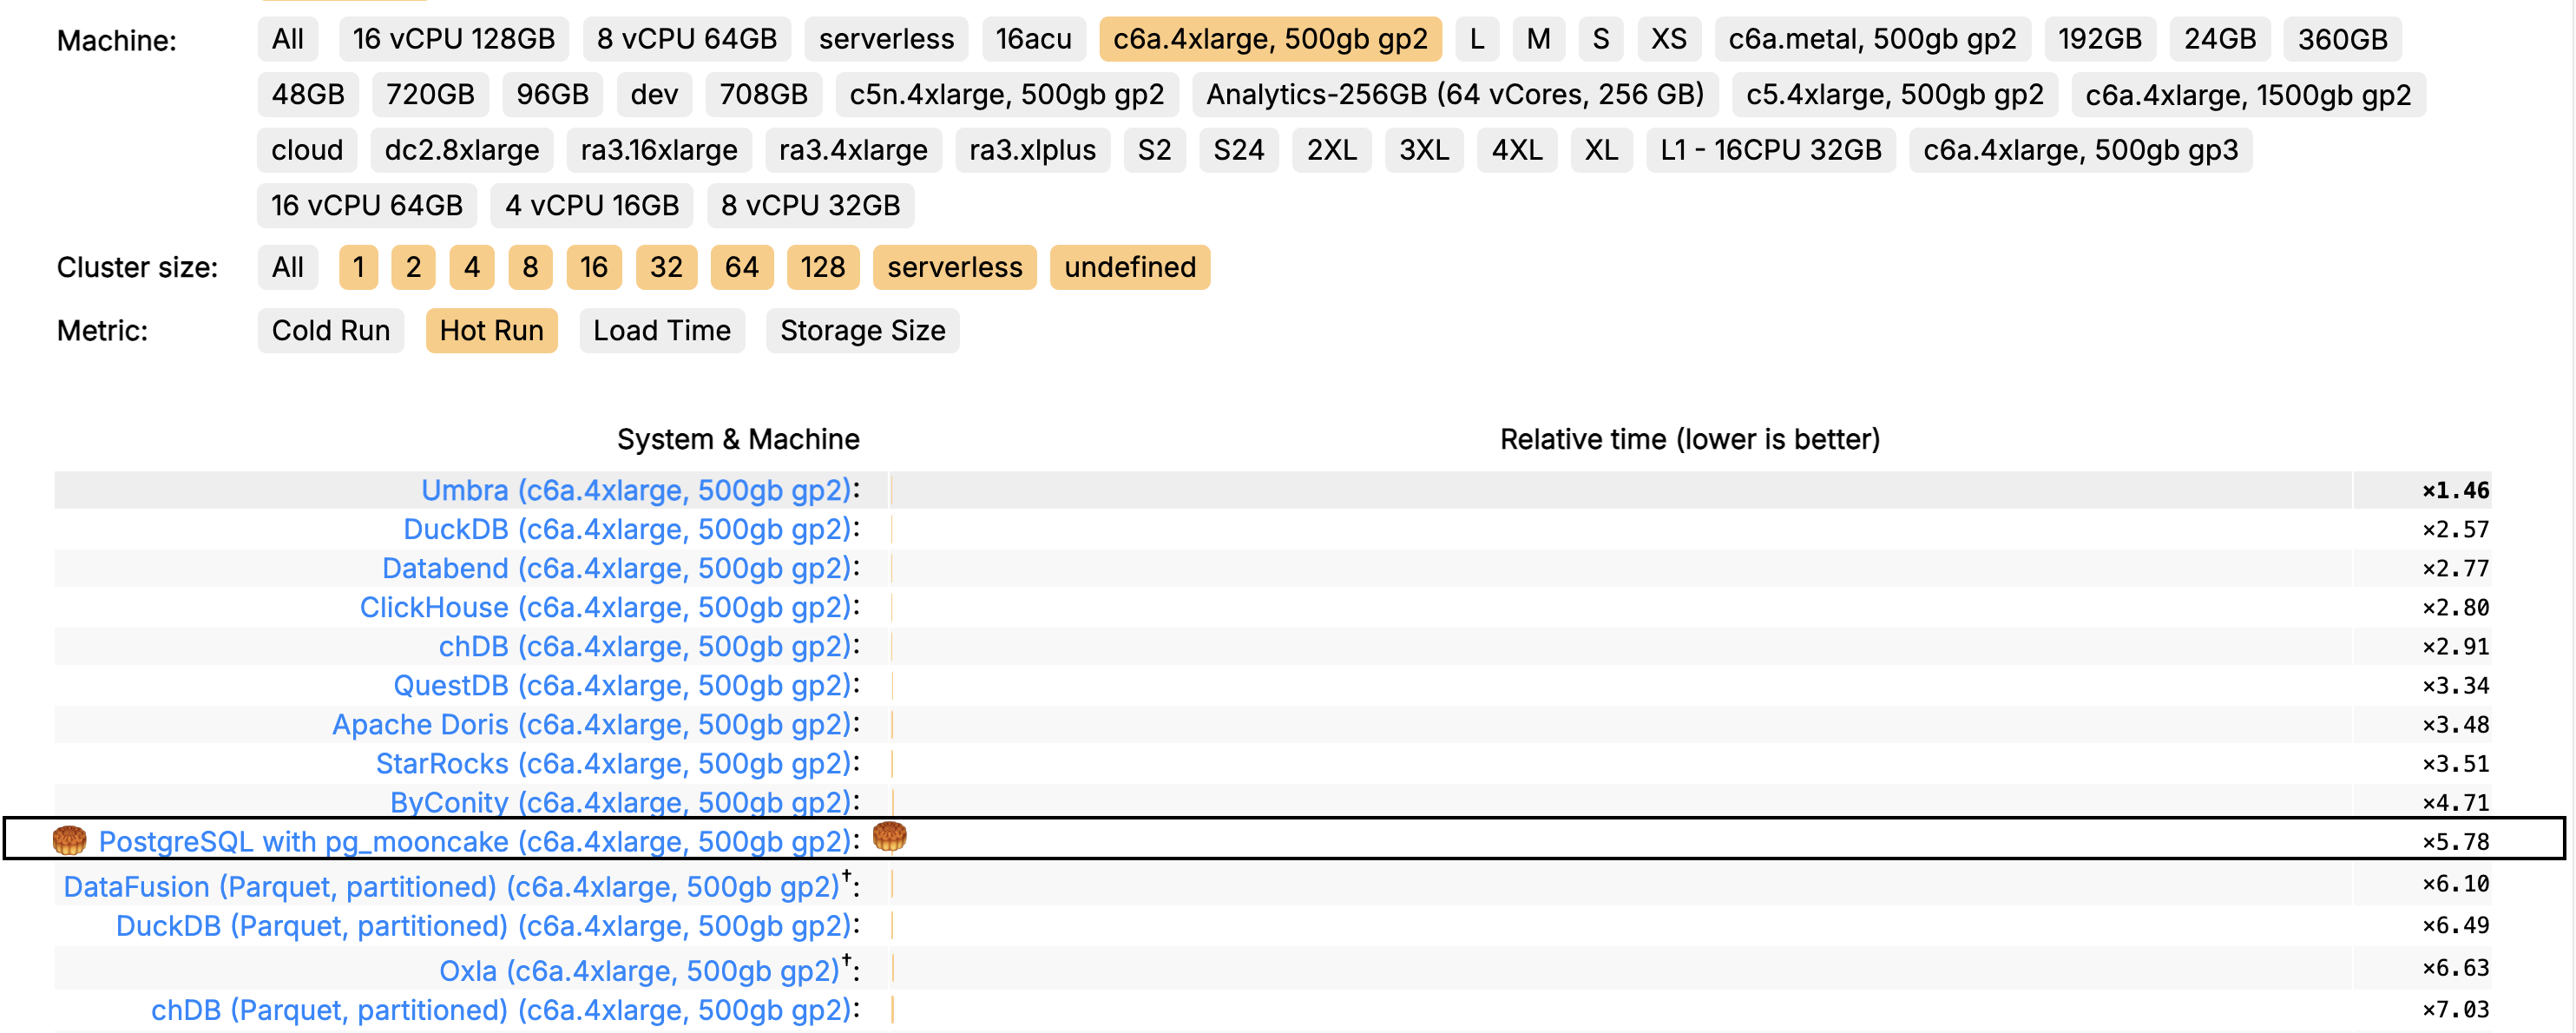
太长不看版(TL;DR): 经过几个月的深度优化,我们让 PostgreSQL 成功闯入了 ClickBench 全球前十——这个榜单长期以来一直被各种专门构建的 OLAP 分析数据库所统治。
更重要的是,所有计算均在 Postgres 进程内完成,所有表均由 PostgreSQL 直接管理——它绝不是一个简单的外部代理包装器。这就是 pg_mooncake 的故事。
什么是 ClickBench?
ClickBench 是实时分析型数据库领域最权威的基准测试,最初由 ClickHouse 团队发起,旨在评估数据库处理真实世界大规模表扫描、多维过滤与复杂聚合查询的能力。
在历史上,ClickHouse 等专用分析型数据库一直在该榜单上遥遥领先,而像 Postgres / MySQL 这样的通用关系型数据库往往慢上 100 倍以上。我们希望打破这一固有印象——而 Postgres 不负众望。
如何在 Postgres 内部构建极速分析引擎?
当大多数人想到 PostgreSQL 时,脑海里浮现的是一台坚如磐石的 OLTP 事务数据库,而不是实时分析引擎。然而,PostgreSQL 无与伦比的可扩展性使它具备了越级挑战的能力。
以下是我们的核心工程路径:
1. 构建原生 PG 扩展
我们充分利用 PostgreSQL 的扩展机制,将 pg_mooncake 构建为原生的 PG 扩展。
2. 存储格式:列式存储(Columnstore)
对于分析型负载而言,列存格式不可或缺。ClickBench 的典型负载是一张极宽的大表,而每条查询通常只访问其中少数几列:
- 在行存表(如 PostgreSQL 原生堆表)中,读取单列意味着必须在磁盘页面上跨行跳跃读取;
- 在列存表中,同一列的数据连续存放,顺序读取极快,且能实现更高的压缩率以及直接在压缩数据上执行计算。
3. 向量化执行(Vectorized Execution)
为了彻底释放列存格式的计算潜力,我们将 DuckDB 嵌入作为列存查询的执行引擎。整个执行管线以向量化批次(Vectorized Batches)而非逐行(Tuple-at-a-time)方式处理数据,充分激活现代 CPU 的 SIMD 指令集,在全表扫描、GROUP BY 分组与聚合计算中展现出极高的吞吐效率。
4. 在 PostgreSQL 内部直接管理表元数据与统计信息
在实时分析中,固定开销与规划延迟至关重要。我们没有在每次查询时去对象存储或 Parquet 文件尾部解析元数据,而是将文件列表与行组(Row Group)统计信息直接持久化在 PostgreSQL 中:
- 大幅缩短查询规划(Query Planning)耗时;
- 支持精细化的文件跳过(File Skipping)与行组裁剪,显著减少不必要的 I/O(详见下一篇深度解析)。
关于整体架构的更多细节,请参阅《pg_mooncake 是如何构建的》。
这意味着什么?
PostgreSQL 不再仅仅是一匹 OLTP 驮马。通过精心的内核工程与架构调优,它完全能够在保留 PostgreSQL 完整生态与灵活性的同时,提供媲美专用 OLAP 数据库的分析性能。
在打造了十年高端数据系统之后,我最核心的信念之一便是:我们可以把现代数据栈变得简单得多。
pg_mooncake 采用 MIT 开源许可证发布,欢迎立即上手体验。
🥮