Iceberg Meetup 参会随想

上个月,我在 Snowflake 总部举办的 Iceberg Meetup 上做了一场演讲。公开演讲从来都不是我的强项,而台下坐着 Snowflake CEO Sridhar 和 Tabular CEO Ryan 更是让人倍感压力。
那天是我创立 Mooncake Labs 的第 18 天,我在演讲中探讨了面向 Apache Iceberg 的通用索引框架(演讲幻灯片见这里)。以下是我从这次聚会中收获的几点启发:
1. 伟大的产品是其社区的映射
过去十年里,我一直在构建一款商业闭源数据库。每当收到新的功能需求时,工程与产品负责人都会花上几个小时评估优先级。几乎每一次,讨论最终都会归结为一个问题:这能带来多少 ARR(年度经常性收入)? 我亲眼看着最优秀的工程师耗费数月时间,去编写那些与整体架构格格不入的定制钩子和扩展。我当时常常想:直接让客户提个 PR 不就好了吗 :) 这种以 ARR 为导向的优先级排序流程,最终拼凑出来的产品往往像下面这个怪异的汉堡一样:
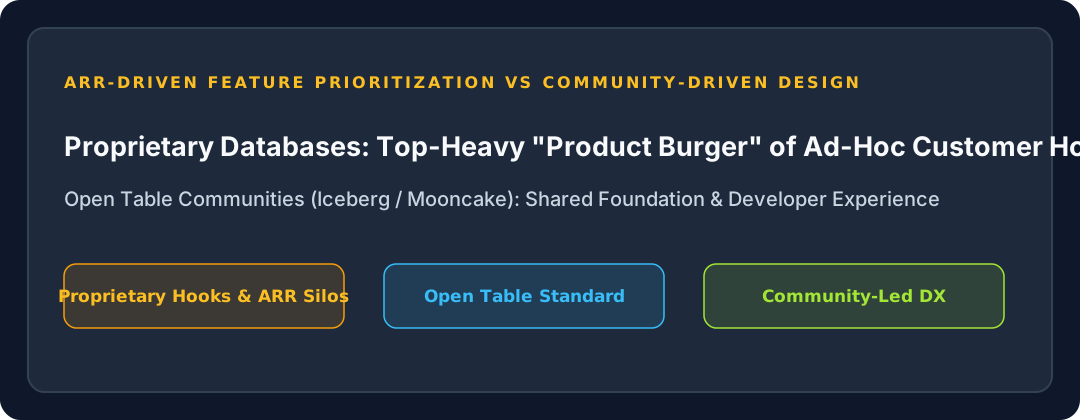
而 Iceberg 社区给人的感觉完全不同。大家有着清晰一致的终极目标,贡献者与用户并肩协作,开发者体验(DX)处于最核心的位置。这种氛围令人耳目一新——这才是打造受人喜爱的产品的正确方式。
我非常期待以开源方式构建 Mooncake 并凝聚社区。成功的产品总是映射出它背后的人群——无论是构建者还是使用者。
2. 开放表格式依然处于极其早期的阶段
虽然现场的许多讨论都聚焦在推进 Iceberg 的技术前沿——例如元数据缓存、v3 格式、优化的删除文件(Deletion Files)——但同样也有大量问题停留在最基础的层面。我经常被问到:“什么是 Catalog(目录),为什么我需要它?”
而在与一些 AI 开发者和产品工程师交流时,这些概念甚至更加陌生:
“Iceberg 到底是个啥 && 什么是数据湖(Lake)?”
这些开发者在 S3 上存了一堆文件,他们其实非常需要“表语义(Table Semantics)”——他们正饱受手动管理文件、用 Python 脚本处理数据、再把处理后的数据集提供给线上应用的折磨。他们本该是湖仓一体(Lakehouse)最直接的受益者,但许多人甚至从没听过这个词。
很显然,我平时生活在 Twitter 数据技术圈的狭小信息茧房里。最前沿的科技巨头确实正在围绕开放表格式进行技术收敛,但距离它成为每一位普通产品工程师手头的标准工具,还有很长的路要走。
首先,开放表格式的接口、语法和术语必须贴合现代应用开发者的习惯。搭建一套数据湖仓基础设施,绝不应该需要十几名专职数据工程师才能搞定。
希望 Mooncake 能在加速这一普及进程中贡献一份力量 🙂
3. 极致的性能突破即将到来
我在 Databricks SQL、DuckDB、Snowflake 和 StarRocks 的一些朋友正在全力针对开放表格式优化他们的查询引擎。我非常熟悉这种技术演进的节奏——它通常从 2 倍的性能提升开始,随后快速产生复利效应,最终带来数量级的飞跃。
有状态(Stateful)系统在 OLTP 或 HTAP 领域永远有一席之地;但我们很难不去畅想这样一个未来:ML/AI 数据处理、分析查询(无论是后台报表还是面向用户的实时分析)以及即席查询(Ad-hoc Queries),都将以完全无状态(Stateless)的方式直接运行在这些开放表格式之上。
我个人最感兴趣的是自适应查询执行(Adaptive Query Execution,参见 PVLDB, 17(12): 3947 - 3959, 2024)领域的进展。这一直是我长期关注的方向,但在过去的经历中我始终未能说服团队将其彻底落地。如今看到它在数据湖仓上的实现甚至超越了大多数传统数据仓库,实在令人振奋!
——在很多方面,开放表格式的时代与当下的 AI 时代颇为相似:前景无比广阔,先行者已经从中斩获巨大成功;但一切才刚刚拉开序幕 🥮