Mooncake:下一代搜索与分析系统


我们是 Zhou、Cheng 和 Pranav。过去十年里,我们一直在 MemSQL(现名 SingleStore)研发数据库内核。
我们热爱复杂系统、硬核工程技术,当然还有——物理学 🙂 数据系统就像物理学一样,建立在若干基本公理之上。这些原则必须自洽且持久。
仅仅打造一个“技术指标上更好”的系统是徒劳的。一个数据系统的成败取决于它所秉持的架构原则,而在中途改变基因几乎是不可能的:闭源商业公司不可能摇身一变成为真正受社区拥戴的开源项目;绑定了私有存储格式的数据库也不可能轻易放弃自己的存储引擎、蜕变为高效的无状态计算引擎。
对于数据领域正在发生的变革以及什么才是正确的方向,我们有着坚定的信念。这些原则共同构成了 Mooncake。
我们非常感激 Khosla Ventures、Nikita Shamgunov、Jordan Tigani、Barry McCardel、Amir Haghighat、Paul Copplestone、Roger Luo 以及众多伙伴的支持。感谢你们相信我们与我们的原则。
1. 现代软件是由“产品工程师”构建的
当今数据社区所构建的接口、行话与技术栈,与现代软件团队真正交付产品的方式之间,存在着巨大的鸿沟。而这正是我们的机会。如今的开发团队主要分为两类:
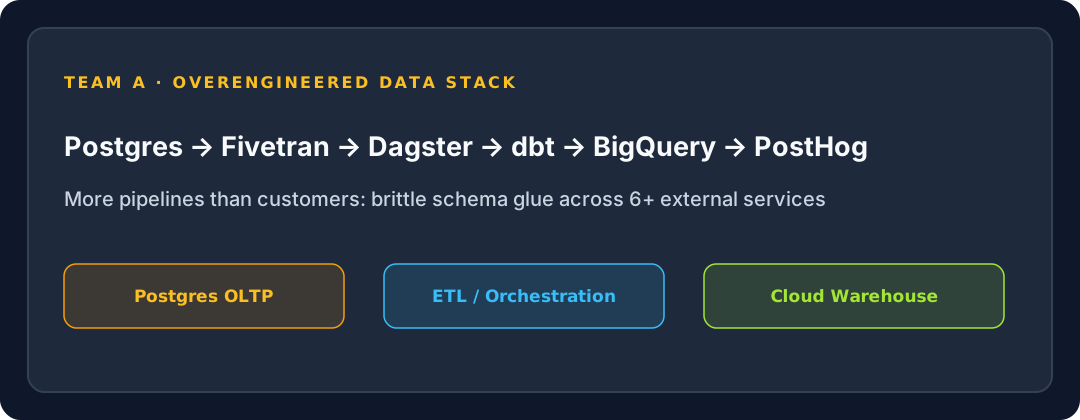
a. 过度工程化的团队(数据管道比客户还多)
这类团队为了交付一款产品,搭建了极其庞杂的基础设施。每一个组件都引入了各自特有的 API、Schema 与数据类型,而整条数据流往往只存在于某一位工程师的脑海里。
我们经常见到的一种典型架构是:Postgres + PostHog + Dagster + Fivetran + dbt + BigQuery——仅仅是为了获取一些最基础的产品使用情况洞察。
尽管我们在数据库领域摸爬滚打了十年,要搭好这套体系也得脱一层皮——更不用说未来的 AI 软件工程智能体(SWE Agent)该如何驾驭它了。而且,你到底什么时候才能真正写产品业务代码,而不是伺候你的数据栈?
b. 亟需规范化数据管理的敏捷团队
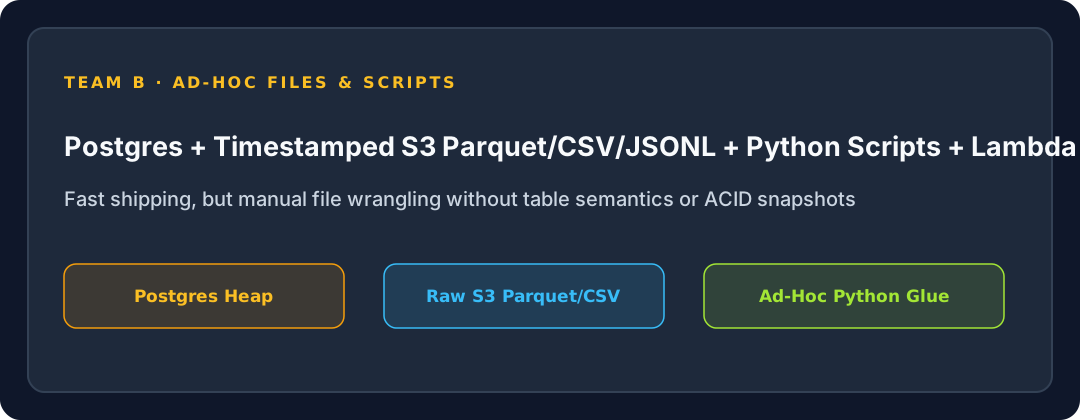
另一类团队在极其精简的基础设施上快速交付了大量产品功能——通常只有一张 Postgres 表、一堆零散文件(CSV、Parquet、JSONL)、Python 脚本和几个粘合一切的 Lambda 函数。
我很欣赏这类团队的执行力,但如果能把数据存进开放表格式(Iceberg 与 Delta Lake)而不是散乱的文件里,他们会轻松得多:再也不用在成百上千个带时间戳的 Parquet 文件里翻找缺失值,也不必在 DataFrame 里痛苦地手工拼接文件与数据库表。
遗憾的是,这些团队往往根本不知道开放表格式技术的存在——这也怪不得他们。数据领域的行话太多、上手门槛太高,搭建整套基础设施的机会成本更是令人望而却步。顺便问一句,你试过直接往一张 Iceberg 表里写数据吗?祝你好运!
2. 数据库执行引擎正在走向同质化与商品化
我们看到几乎所有数据库都在实现相同的优化技术,彼此模仿。数据库领域的蛋糕被切得如此细碎,以至于市场上只剩下诸如“实时!”、“极速分析!”之类空洞的营销词汇。
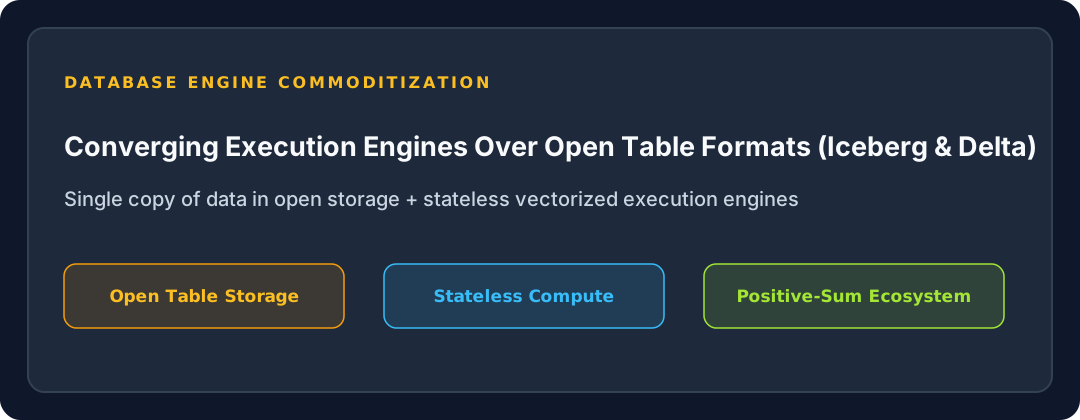
这正是我们坚定看好 Apache Iceberg 和 Delta Lake 等开放表格式的原因:在开放存储中只保留一份数据副本,并由不同的无状态执行引擎按需计算,能够让各方激励保持一致,创造真正的正和博弈。
3. AI 智能体(Agents)同样需要存算分离
存算分离在历史上为“人类开发者”创造了极佳的体验:Serverless、数据分支(Branching)、只读副本、缩容至零(Scale to 0)以及更低的成本。
对于 AI 智能体而言,存算分离同样具有不可抗拒的吸引力。随着思维链(Chain-of-Thought)与推理模型的发展,LLM 不再局限于对固定知识库发起简单的函数调用——智能体将会频繁地写入和更新数据表,并使用 Python 执行复杂的数据转换。
Mooncake 的核心拼图:你只需要 Postgres 和 Python
首先,借助 pg_mooncake 列存表,你可以直接在 PostgreSQL 内部获得快 1000 倍的分析性能,而使用体验就像操作普通 Postgres 表一样简单自然。
“我们非常兴奋看到 Mooncake 将易用的列存表带入 Postgres……Mooncake 正是我们在保持 Postgres 架构不变的前提下实现数据基础设施现代化所需要的关键拼图。”
— Max Muoto
其次,在 Postgres 之外,你可以直接使用 Polars、DuckDB 和 Pandas 查询这些底层开放格式表,无需任何繁琐的 DataFrame 转换或格式清洗。
创业第 61 天,前方还有许多系统等待我们超越 🙂
前路漫漫,但我们的核心原则不会改变。
🥮