这是本节的多页打印视图。 .
Mooncake 工程技术博客
-
1: 工程与深度技术解析
- 1.1: 将 pg_mooncake 与 duckdb_mooncake 迁移至 DuckDB 2.0、pg_duckdb 1.2.0 与 pgrx 0.19.3
- 1.2: Mooncake 正式加入 Databricks!
- 1.3: Mooncake 技术白皮书:面向 Apache Iceberg 的实时存储引擎
- 1.4: 不,单靠 Iceberg 拯救不了你的数据栈
- 1.5: 可是,我的 Postgres(+ 数据湖仓)是免费的呀
- 1.6: HTAP 已死,精神长存
- 1.7: “在 Postgres 中做分析”究竟意味着什么?
- 1.8: 如何让 DuckDB 在 Parquet 文件上的查询性能再上一个台阶
- 1.9: ClickBench 基准测试证明:Postgres 是一流的分析型数据库
- 1.10: S3 Tables 究竟是个啥?
- 1.11: pg_mooncake 🤝 Drizzle:用强类型 ORM 驱动分析查询
- 1.12: pg_mooncake + Neon:PostgreSQL 中的 Serverless 实时分析
- 1.13: pg_mooncake:基于列存表与 DuckDB 的 Postgres 极速分析引擎
- 1.14: Mooncake:下一代搜索与分析系统
- 1.15: Iceberg Meetup 参会随想
- 1.16: 我们学到的几条铁律
- 2: 版本发布说明
1 - 工程与深度技术解析
1.1 - 将 pg_mooncake 与 duckdb_mooncake 迁移至 DuckDB 2.0、pg_duckdb 1.2.0 与 pgrx 0.19.3
当 Mooncake Labs 在发布 v0.2.0 后暂停对 pg_mooncake 的公开更新时,该扩展停留在早期的 DuckDB 1.3.x / pg_duckdb 快照与 pgrx 0.12 上。与此同时,PostgreSQL 社区已经演进至 PostgreSQL 18、pgrx 0.19.3 以及基于 DuckDB v2.0.0 的 pg_duckdb 1.2.0。
本文将深入介绍我们将整个 Mooncake 技术栈——pg_mooncake v0.3.0、duckdb_mooncake v0.0.2 与 moonlink v0.0.1——全面迁移至 DuckDB 2.0.0、pg_duckdb 1.2.0 与 pgrx 0.19.3 的工程改造过程。
架构回顾:三大代码仓库如何协同工作
理解这三个仓库在编译期与运行时的边界,有助于看清为什么升级 DuckDB 会同时涉及跨多个 crate 的 C++ 与 Rust 代码改造:
pg_mooncake是基于pgrx的 Rust 扩展,负责提供mooncake.create_table(dst, src)接口、拉起mooncake_worker后台进程、将逻辑复制变更流式写入内嵌的moonlink引擎,并将duckdb_mooncake编译进同一个动态库中。pg_duckdb在 PostgreSQL 进程内嵌了libduckdb(v2.0.0),负责拦截并接管涉及columnstore表的分析查询。duckdb_mooncake注册了名为mooncake的 DuckDBStorageExtension(存储扩展),通过 Moonlink 的 UNIX 域套接字(mooncake.sock)解析列存表元数据,等待目标 PostgreSQL WAL LSN 同步完成,并将底层文件扫描委托给 DuckDB 的并行parquet_scan读取器以及内存态 Puffin 删除向量读取器。
1. 将 duckdb_mooncake 适配至 DuckDB 2.0.0 C++ 接口
DuckDB 2.0.0(d54cbbe3df17e8e5ce68312f483b4155836112aa)在目录管理(Catalog)、存储扩展(StorageExtension)以及谓词下推(TableFilterSet)层引入了多项不兼容的 C++ API 变更:
StorageExtension 注册方式(StorageExtension::Register)
在 DuckDB 1.x 中,扩展直接修改 config.storage_extensions["mooncake"] 字典;而在 DuckDB 2.0 中,存储扩展统一通过 StorageExtension::Register(config, "mooncake", make_shared_ptr<MooncakeStorageExtension>()) 注册,且 StorageExtensionInfo 结构体的虚表与回调签名也随之更新。
TableCatalogEntry::GetColumns() 与 GetTypes()
MooncakeTableEntry 继承自 TableCatalogEntry。我们将其构造函数与列投影辅助方法对齐至 DuckDB 2.0 的 ColumnList 与 LogicalType 接口,同时保留了供 Moonlink 删除向量使用的虚拟伪列 __row_id(UBIGINT)。
TableFilterSet 迭代器重构与 IS NULL 谓词下推修复
在 DuckDB 1.x 中,TableFilterSet 直接暴露了 std::unordered_map<idx_t, unique_ptr<TableFilter>> filters 成员变量;而在 DuckDB 2.0 中,TableFilterSet 封装了内部映射,改为提供返回 (FilterIndex, const TableFilter &) 的迭代器接口。
在将 MooncakeScanFunction::mooncake_scan_bind 迁移至新迭代器接口的过程中,我们定位并修复了一个隐藏在 IS NULL / IS NOT NULL 谓词下推中的列索引重映射缺陷:
- 当查询只投影部分列(例如
SELECT b FROM t_col WHERE a IS NOT NULL AND b > 10)时,CONJUNCTION_AND与比较谓词都会将列索引从扫描投影下标重映射为底层 Parquet 物理表列下标(column_ids[filter_col_idx]),但原先的IS_NULL与IS_NOT_NULL分支却直接将未映射的投影下标传给了底层 Parquet 过滤器集合。 - 在 DuckDB 2.0 下,当执行
SELECT count(*) FROM (SELECT DISTINCT c, a, b FROM t WHERE c IS NULL AND b > 2)时,错位的列索引会导致parquet_scan触发段错误(SIGSEGV)。 - 通过
column_ids统一重映射IS_NULL与IS_NOT_NULL的列索引后,该崩溃问题彻底消除。
2. 跨 pg_mooncake 与 duckdb_mooncake 打通 LSN 一致性快照读取
由于 pg_mooncake 通过 PostgreSQL 逻辑复制异步消费行存表写入,紧跟在 INSERT 或 COMMIT 之后执行的 SELECT 必须等待 moonlink 消费完当前已刷盘的 WAL 位置,才能保证“读己之所写(Read-Your-Own-Writes)”。
在 v0.3.0 中,我们打通了跨动态库的 LSN 桥接机制:
- 在
pg_mooncake(src/lib.rs)中导出 C 符号: - 在
duckdb_mooncake中,存储扩展在运行时通过dlsym(RTLD_DEFAULT, "mooncake_get_postgres_lsn")解析该符号(若duckdb_mooncake运行在 PostgreSQL 进程之外的独立 DuckDB CLI 中,则自动回退至0)。 - 当绑定
columnstore表扫描时,duckdb_mooncake将获取到的 LSN 传入moonlink_scan_table_begin(...),由 Moonlink 阻塞等待直至逻辑复制消费进度追上目标 LSN。
3. 分区表层级自动设置 REPLICA IDENTITY FULL
PostgreSQL 逻辑复制要求无主键表(或需要获取更新/删除前完整旧元组的表)启用 REPLICA IDENTITY FULL。当用户对分区表执行 CALL mooncake.create_table('sales_col', 'sales') 时,仅在父分区表上设置 REPLICA IDENTITY FULL 并不会自动向下传播到已有的叶子分区。
pg_mooncake 0.3.0 在 mooncake.create_table 中调用 pg_sys::find_all_inheritors(relid, pg_sys::AccessExclusiveLock as i32, std::ptr::null_mut()),在单次原子操作中为父表及所有现有子分区统一设置 REPLICA IDENTITY FULL。
4. 端到端实机验证
完成适配的技术栈已在两套纯净的 Linux ARM64 环境中通过完整验证:
- Ubuntu 24.04.5 LTS ARM64(
mooncake-u24a-pg18,PostgreSQL18.6) - Rocky Linux 10.2 ARM64(
mooncake-el10a-pg17,PostgreSQL17.11)
全部 58 项 Moonlink table_handler 单元测试、3 组 SQL 回归测试集(small、partition、unsupported)、pg_duckdb 1.2.0 运行时版本校验门禁以及 13 项数据库重启持久化与 Iceberg 元数据检查点均零失败通过。
1.2 - Mooncake 正式加入 Databricks!
十三个月前,我们创立了 Mooncake,旨在将支撑 OpenAI 等科技巨头的数据智能技术栈带给每一个现代应用与每一位开发者——从第一行 Prompt 直到公司上市(IPO)。
今天,我们正式加入 Databricks。 我们的使命一如既往:让 Lakebase(Postgres)与数据湖仓(Lakehouse)融为一体。
在过去整整十年里,我们曾以为数据库的终极形态是一个能包揽一切的单体系统——同时兼顾高频更新、分布式事务与极速分析。在数据库行业里,这被称为 HTAP。但它始终未能真正普及。Zhou 和 Cheng 亲手构建了它,Pranav 竭力向市场推销它——这条路走得异常艰难。
因为当你试图在一套系统里同时重造 OLTP 和 OLAP 两端时,最终造出来的产品往往在两端都不得不做出妥协。
那么,如果不去重造两端呢?🥮
开发者(以及如今的 AI 智能体)早就已经选出了默认的 OLTP 赢家:Postgres,而且大家都深爱着它。
与此同时,企业也已经拥有了默认的数据湖仓(Lakehouse),并且非常熟悉如何用自己钟爱的计算引擎(Apache Spark、Snowflake、DuckDB、Trino)或智能体框架(Databricks Agent Bricks)从中提炼数据智能。
在天平的两端,赢家都已经尘埃落定:云原生架构、庞大的开源社区拥护。在数据库历史上,操作型(Operational)与分析型(Analytical)两大疆域第一次同时拥有了如此清晰的标准锚点。
既然如此……如果让它们无缝协同工作呢?
面向开发者
你的应用从第一天起就跑在 Postgres 上。一旦你的产品找到市场契合点(PMF),同一份数据立刻就能直接供最顶尖的湖仓工具进行深度分析与 AI 训练——不需要搭建脆弱的数据管道,也不需要手工折腾 CDC,Postgres 数据天然与你的湖仓实时同步。
而所有的分析洞察与智能,只需借助 Postgres 与 pg_mooncake 扩展即可直接服务于线上应用。
面向企业
对于现代企业而言,Postgres + Lakehouse 早已是既定的标准技术栈。成群的数据工程师每天在两者之间搬运数据(ETL、Reverse ETL),还有更多工程师在维护和调优数据湖仓。
有了 Mooncake,整套技术栈直接开箱即用——再也不需要为了同步一张表而维护一套沉重的 Debezium + Kafka + Flink 集群 🙂
面向 AI 智能体(Agents)
我们看到智能体与数据的交互主要分为两类:
- 在 Postgres 上自动构建应用的智能体(如 Lovable、Replit);
- 分析并理解企业数据的智能体(如 Agent Bricks)。
现在,这两类智能体终于可以在同一份数据上并肩协作了:
- 共享同一份实时数据;
- 支撑上万个并发智能体同时运行的规模;
- 无需人工编写和维护连接两端的 ETL 管道 🙂
衷心感谢,以及属于我们的又一个 Day 0
感谢所有一路支持和相信我们的人——用户、早期设计合作伙伴、投资人以及开源社区贡献者。
pg_mooncake 将继续保持开源与社区活力(注:现由 PGSTY 社区 持续维护并发布 v0.3.0)。
加入 Databricks 后,Mooncake 同时连接起了两大核心数据疆域:Postgres(Lakebase)与 Lakehouse。终于,天平的两端真正融为了一体。
—— Zhou, Cheng, Pranav, Nolan, Hao, Paul. 🥮
1.3 - Mooncake 技术白皮书:面向 Apache Iceberg 的实时存储引擎
这篇技术白皮书假设读者已对开放分析表格式 Apache Iceberg 有所了解。Iceberg 是现代“数据湖仓(Lakehouse)”运动的核心基石,它允许用户:
- 将大规模数据集以开放文件格式(Parquet + 元数据)存储在廉价对象存储中;
- 使用 Spark、Trino、Flink、DuckDB 等多种计算引擎通过 SQL 直接查询;
- 获得 Schema 演进与时间旅行(Time Travel)等数据库级特性;
- 实现近乎无限的弹性扩展,彻底摆脱单一供应商锁定。
然而,Iceberg 生来是为低频变更数据与批量分析处理而设计的。在批处理领域,随着各大引擎对开放格式读取能力的持续优化,这套体系已经非常成熟。
但对于实时工作负载(面向用户的实时分析、高频 CDC 同步、流处理),企业往往不得不额外部署一套专门的实时系统(如 ClickHouse、Druid、SingleStore),并同时维护两条数据管道,在两套系统之间来回搬运数据。
如果我们能将湖仓一体的开放性与灵活性带入实时领域呢?这需要同时满足两大核心要求:
- 绝不牺牲湖仓一体的任何生态优势:完全兼容标准 Iceberg 生态与多引擎互操作;
- 引入亚秒级实时数据与极速查询:同时绝不破坏底层 Iceberg 表的读取性能与元数据整洁度(避免小文件爆炸)。
1. 简介
Mooncake 是构建在 Apache Iceberg 之上的实时存储引擎。它在不牺牲数据湖仓开放性的前提下,为 Iceberg 注入了三大核心能力:
- 高速流式摄取(Fast Ingest):支持流式写入与来自关系型数据库的亚秒级实时镜像同步;
- 极速分析查询(Fast Queries):持续后台表优化与智能缓存;
- 原生索引层(Indexing):支持低延迟搜索与主键点查。
Mooncake 的架构、索引层与写感知(Write-Aware)优化将 Iceberg 转变为一个能够直接承载面向用户的实时分析、全文检索、在线服务与 HTAP 负载的统一平台。
2. 整体架构
Mooncake 的核心引擎是 moonlink——一个专为实时 CDC 与流式写入 Iceberg 而设计的 Rust 存储库。
Moonlink 为每一张 Iceberg 表配备了内存 Arrow 写缓冲区(Arrow Buffer)、位置删除日志(Positional Delete Log)以及跨越内存 / 本地 NVMe / 对象存储的混合索引层,用以吸收高频增删改操作。计算引擎通过联合读取(Union Read)同时扫描内存缓冲与已固化的 Iceberg 文件,从而无需等待高开销的 Iceberg 元数据提交即可获得亚秒级最新视图。
写入(Inserts)
- 新插入的行首先写入内存中的 Arrow 写缓冲区;当累积到设定阈值后,高效刷盘生成紧凑的 Parquet 文件;
- 在写入过程中同步构建内存索引,并在 Parquet 刷盘时将其持久化为对象存储原生的索引文件。
删除与更新(Deletions)
- Moonlink 为所有行维护主键哈希索引;
- 当收到
DELETE或UPDATE时,利用主键索引快速定位目标行的(file_id, row_offset)并更新位置删除日志; - 定期将位置删除日志转换为符合 Iceberg 规范的 Puffin 删除向量(Deletion Vectors)。
读取(Reads)
- Moonlink 生成标准的 Iceberg 表快照,供任何外部引擎直接读取;
- 同时,Moonlink 暴露了实时联合读取接口(由
duckdb_mooncake调用),将内存缓冲状态与底层 Parquet/Puffin 文件无缝合并,提供强一致的亚秒级实时读取。
3. 核心技术深度剖析
3.1 写感知的表优化(Write-Aware Table Optimization)
最新版本的实时联合读取(Union-Read) 传统 Iceberg 迫使用户在“数据新鲜度”与“写放大”之间做痛苦权衡:为了获得更新鲜的数据,用户必须频繁提交快照,结果产生海量微小的 Parquet 文件和 Manifest 清单文件。Mooncake 通过周期性提交 Iceberg 快照、同时在两次快照之间提供实时合并读取接口,彻底打破了这一桎梏——既保持了对象存储上 Iceberg 文件的紧凑整洁,又实现了亚秒级读取新鲜度。
主键索引 + 位置删除向量(Deletion Vectors)处理高频更新/删除 传统 Iceberg 在处理高频 CDC 更新时,要么依赖极其昂贵的全局 Merge-on-Read(Equality Deletes,严重拖慢读取性能并产生小文件),要么只能做高延迟批处理合并。Moonlink 维护了同时覆盖内存缓冲区与已刷盘 Parquet 文件的哈希索引,能够在微秒级定位被删改行的物理行号,并通过位图形式的 Puffin 删除向量(Roaring Bitmap)高效屏蔽旧行。
优雅化解实时写入与后台 Compaction 的并发冲突 在传统开放表格式中,后台 Compaction 任务与前台流式写入极易发生乐观锁冲突导致事务失败重试。Moonlink 在后台执行文件合并与重排序时,会精确维护旧文件行偏移量到新文件行偏移量的重映射表(Remapping State),自动将合并期间并发到达的删除与更新重定向到新文件上,从而实现零事务冲突、无锁在线合并。
3.2 Iceberg 原生索引架构
索引存储格式
- 索引元数据以标准 Iceberg Puffin 文件形式存储;
- 每个索引文件对应一个或多个底层 Parquet 数据文件,并由后台以 LSM 树方式分层合并(Index Merge)。
索引类型实现
- 分桶哈希表(Bucket Hash Table):面向高基数主键的不可变、按哈希序排列的類 SSTable 索引结构(
mooncake_hash_index),将 64 位哈希值映射至(file_id, row_offset),将按值删除高效转化为位置删除。 - 分桶哈希表 + 倒排索引:面向低基数列与全文检索(GIN)的合并式倒排索引。
- 向量索引:面向 AI 检索的对象存储原生分块 IVF 向量索引。
3.3 托管缓冲区与多级缓存
- 对象存储原生 WAL:对象存储是唯一的持久事实来源,节点恢复时可直接重放 WAL;
- Arrow 内存流式写缓冲:支持单机百万级更新吞吐,并可直接向实时计算引擎零拷贝传输 Arrow/Parquet 数据;
- NVMe 读写穿透缓存:最新生成的 Parquet、删除向量与索引文件先落盘本地 NVMe,再异步上传至 S3,使本地读写延迟稳定在
<5 ms。
4. 部署形态与解决方案
4.1 pg_mooncake
在 PostgreSQL 内部一站式实现 HTAP、实时分析与 Iceberg 湖仓同步。pg_mooncake 在 Postgres 后台工作进程中运行内嵌的 Moonlink 引擎,并通过 pg_duckdb 嵌入 DuckDB 作为向量化执行引擎(MIT 许可)。
只需调用 CALL mooncake.create_table('T_mooncake', 'T_heap'),即可为任意 Postgres 堆表创建亚秒级实时同步、支持 LSN 强一致快照读取的列存镜像表。
4.2 独立运行的 moonlink 服务
无状态的 Rust 实时同步与流式摄取服务,支持通过逻辑复制或 HTTP/gRPC 接口摄取变更并直接写入 Apache Iceberg,以极低开销维护随时可查的实时湖仓表。
1.4 - 不,单靠 Iceberg 拯救不了你的数据栈
人生总是充满了“理想与现实的落差”。今天我们就来聊聊数据社区的新宠——Apache Iceberg 的理想与现实。
理想:Iceberg 能解决我所有的数据痛点
平心而论,Iceberg 的核心设计理念非常漂亮:
- 将所有数据以 Parquet 等开放文件格式存放在对象存储中;
- 让任何计算引擎(DuckDB、ClickHouse、Spark、Snowflake 等)把这些文件当作一张真正的数据库表,直接用 SQL 查询;
- [持续演进中] 无需将数据导入特定系统的私有格式,就能直接获得优异的查询性能。
凭借精巧的元数据层设计,你还能获得:
- 跨执行引擎的互操作性,彻底摆脱存储层供应商锁定;
- ACID 事务与 Schema 演进;
- 真正的存算分离;
- 时间旅行(Time Travel)与多版本快照管理。
Iceberg 最初是由 Netflix、Apple 等硅谷巨头的超大规模大数据团队构建的;而最近,越来越多的云平台开始尝试将它推向普通开发者(例如 Supabase 的 Analytics Buckets 与 Tiger Lake)。
听起来简直完美:作为用户,我(1)在自己的对象存储桶里掌控全部数据,(2)不被任何数据库厂商锁定,(3)无需导数据就能用任意引擎直接查询。剧本本该到此圆满落幕。
现实:只有当你愿意“自己动手造一个 Snowflake(BYOS)”时,Iceberg 才很酷
对于 Apple 和 Netflix 而言,雇佣几百名顶尖基础设施工程师,在裸对象存储之上自己造一套 Snowflake 或 Databricks 绝对物超所值。但对于你我这样的普通团队,我对此深表怀疑。
当你我满怀期待地用上 Iceberg 时,我们以为它会像 Postgres 或 ClickHouse 一样“开箱即用”——直接 INSERT / UPSERT 数据、导入文件、然后发起查询。然而现实远没有那么简单:
1. 沉重的元数据开销: Iceberg 需要追踪快照(Snapshots)、清单(Manifests)、清单列表(Manifest Lists)以及表元数据 JSON。哪怕只更新一行数据,也会触发 4 次 S3 写入(每次耗时数百毫秒),而跑在 SSD 上的普通关系型数据库只需不到 1 ms。高频更新带来的直接恶果就是臭名昭著的**“小文件爆炸(Small File Explosion)”**——而且这些碎文件的治理完全丢给了用户自己。对于习惯了 RDBMS 全自动巡航(Auto-Pilot)的开发者来说,这简直匪夷所思。
2. 极其有限的写入并发: Iceberg 采用乐观并发控制(OCC)。每个写入端都假设没有冲突并尝试提交新元数据;一旦两个写入任务撞车,其中一个就会失败并重试。这虽然保证了可串行化隔离,却牺牲了写入吞吐——同一张 Iceberg 表每分钟只能承受寥寥数次无冲突提交,而关系型数据库每秒可以轻松处理数千个并发事务。
3. 读写性能的艰难权衡: 正如 Snowflake 的 Iceberg 官方文档所坦承的:“查询性能主要取决于底层 Parquet 文件写得有多高效。” 如果外部引擎写出的文件不够规整,查询速度就会一落千丈。要想用好 Iceberg,你必须持续投入计算资源去跑分区、排序和 OPTIMIZE 合并任务。这笔维护税在 Netflix 规模下完全值得,但普通开发者早已习惯了无需操心的托管数据库。
4. 面向批处理与延迟数据: Iceberg 生来就是为低频变更的大规模事实表设计的,缺乏真正的流式摄取与实时索引能力——你最终依然不得不额外部署一套实时列存系统。
那么,各方都在如何尝试“修补” Iceberg?
- AWS / Cloudflare R2: “我只负责托管你的文件,剩下的都是你自己的问题。” 给你提供基础的 CDC 连接器和按量计费的后台 Compaction,但小文件爆炸的账单与查询调优依然由你买单。
- Snowflake: “它完全兼容 Iceberg——只要你把管理权交给我。” 读取外部 Iceberg 表没问题;但如果你想要高性能写入和自动优化?请把它转换成 Snowflake 托管的 Iceberg 表——本质上就是披了一层 Iceberg 外壳的 Snowflake(例如 Snowflake 会写出最契合自家缓存节点的 16MB Parquet 文件,而外部引擎通常推荐 256MB–1GB)。
- DuckLake(DuckDB 团队): “Iceberg 的元数据规范从根上就错了,我们重写一套吧。” 不再往 S3 里塞几十个 JSON/Avro 清单文件,而是直接把元数据存在真正的嵌入式关系型数据库(DuckDB / SQLite / Postgres)里,从而实现极速规划与高并发事务。
- Apache Hudi / Paimon: “Iceberg 格式本身太难支持流式更新了,我们造个新格式。” 面向事件流驱动场景(如 Uber、阿里巴巴),将 Compaction、索引和 LSM 树直接内建到表格式规范中。
如果直接赋予 Iceberg 真正的数据库工程学(Database Ergonomics)呢?
在外人看来,“大数据工程师”和“数据库内核工程师”似乎差不多;但我们看待同一份规范的视角截然不同。
大数据背景的工程师看到“表(Table)”时,想到的是 JSON 元数据文件、定时 Compaction 管道、最终一致的 Catalog 状态——“脏数据留给晚上的 Spark 任务去清理就好了”。
而作为一名写了十年数据库内核的工程师,我脑海里第一反应是:索引、并发控制、事务隔离、热数据写入缓冲、查询优化。我一直在想:如果我们把关系型数据库里最成熟、最天经地义的内核机制提取出来,作为一层实时引擎包裹在 Iceberg 之上呢?如果我们不再把 Iceberg 当成供在神坛上的文件规范,而是把它视为现代 RDBMS 的开放后端存储层呢?
让我们设定几条连 SQLite 都能轻松做到的基本底线:
1. 真正可用的高并发写入与流式摄取 告别“单写入端”限制与重试风暴,允许多个写入端并发追加、更新甚至删除数据,且不会互相覆盖或往 S3 里倾倒海量元数据垃圾。
2. 永远不会阻塞或中断写入的后台自动优化 后台 Compaction 应当全自动、无锁、持续在线运行,永远不会与正在进行的业务查询或实时写入发生冲突回滚。
3. 原生内建的索引与智能缓存 不是所有查询都应该退化为十亿行全表扫描。支持在表上定义主键哈希索引、倒排索引或向量索引,并与表数据一同持久化,供任意计算引擎加速检索。
最不可思议的是:这其实并不难实现
这既不是天方夜谭,甚至都不算什么全新发明——我们在关系型数据库内核里已经把这套机制锤炼了几十年:
- 用轻量级 WAL 记录已提交的实时变更;
- 维护主键哈希索引,将按值更新/删除直接转化为精准的位置删除向量(Positional Deletion Vectors),告别全表扫描;
- 记录后台 Compaction 的文件映射状态,在合并期间自动重映射(Remap)并发到达的删除与更新,实现零冲突提交;
- 将构建好的索引打包为符合标准的 Iceberg Puffin 文件,随表一同存储在对象存储上。
这样一来,你完整保留了开放格式、存算分离、时间旅行与跨引擎互操作;同时你又获得了真正关系型数据库般的丝滑体验与实时性能。
Apache Iceberg 不需要被推翻重来——它只需要一点帮助,学会像真正的数据库一样思考。
这就是 🥮 的使命——从 Moonlink 开始,提供开箱即用、亚秒级延迟的 Postgres 到 Iceberg 实时同步。
1.5 - 可是,我的 Postgres(+ 数据湖仓)是免费的呀
友情提示: 你的 Postgres 和数据湖仓(Lakehouse)同样是自由且开源的——你完全不需要成为(或者像巨头一样挥霍数亿美金)才能拥有它们。
为什么是 Postgres + Lakehouse?
原因一:如果你相信 AI,这就是智能体(Agent)的标准技术栈
AI 智能体需要记忆——既需要即时响应的工作记忆(Working Memory),也需要海量的长期知识(Long-Term Knowledge)。
工作记忆必须像应用状态一样瞬时可达、可靠且精确。存放它的最佳位置是哪里?Postgres。无论是传统应用还是 AI 智能体皆是如此。这类状态通常与单个用户、租户或智能体会话紧密绑定。
而长期知识则截然不同:原始输入规模庞大、结构繁杂,并且需要跨用户、跨租户、跨智能体共享——包括全量运行日志、LLM 输入输出轨迹与交互反馈。它的核心目标是让系统“变得更聪明”。
存放这些海量原始输入的最佳方式是什么?数据湖仓(Lakehouse)。它以对象存储为中心、具备无限扩展能力,并且向所有最优秀的计算、分析、搜索与 MLOps 引擎完全开放——同一份数据可供所有工具直接读取,且只需按实际使用量付费。
经典的数据工程管道旨在从应用业务数据中提炼洞察并反哺应用:
App 业务数据 → Bronze(原始层)→ Silver(清洗层)→ Gold(建模层)→ 将洞察服务于 App
而在 AI 智能体时代,完全相同的闭环正在重演:
Agent 上下文 → 原始记忆(Raw Memory)→ 提炼知识(Knowledge)→ 更精准的上下文
Postgres → Lake → Postgres:一个完美的闭环。
原因二:巨头们亟需新的 OLTP 增长故事
OLTP 正在成为数据巨头与超大规模云厂商争夺的全新主战场。
十年前 Snowflake 刚问世时,所有人都为之惊叹:一个无论查询多复杂、数据量多大都能直接跑出结果的云原生数据仓库,真正做到了开箱即用。
但十年后的今天,支撑 Snowflake 的两大核心技术已经高度商品化:
- 存算分离——如今只需对象存储配合智能缓存即可实现;
- 向量化执行——如今在你的笔记本电脑上跑一个 DuckDB 就能轻松拥有。
这使得新一代湖仓架构(Lakehouse)成为必然:将数据与元数据放在开放对象存储中,用任意向量化引擎直接查询。单纯的云数仓市场已不再是暴利蓝海,正在变得同质化。
那么,作为一家估值数百亿的分析型数据巨头,如何向资本市场讲出下一个 10 倍增长故事?答案是:把目光投向隔壁的 OLTP 市场。
过去 40 年里,Oracle、SQL Server 和 DB2 统治着核心 Tier-1 负载,MySQL 占据着互联网 Tier-3 负载。但风向已经彻底改变:
- 单机硬件性能突飞猛进;
- 云基础设施日益成熟;
- MySQL 被 Oracle 收购后步履放缓;
- PostgreSQL 社区以惊人的速度持续进化;
- 绝大多数企业的 OLTP 数据规模并没有无限膨胀。
转眼间,开源、可靠、可扩展且迭代飞快的 Postgres 已经成为 Tier-2 乃至许多 Tier-1 核心负载的首选。
这难道只是 Zhou 的一家之言吗?
看看各大巨头正在做什么就清楚了:
- Microsoft: Fabric(数据湖仓)已经内置了 SQL Server 实时镜像(Mirroring),猜猜下一个接入的是谁?当然是 Postgres。
- Google: AlloyDB (Postgres) + BigQuery,两者正通过 Apache Iceberg 实现底层数据互通。
- Amazon: Aurora 与 RDS 配合 S3 Tables、Glue 与 SageMaker——S3 本身正在变成一座原生的 Iceberg 湖仓。
- Supabase: 推荐阅读他们近期发布的博文 Open Data Standards: Postgres, OTel, Iceberg。
- ClickHouse: 在收购 PeerDB 后,Postgres 已成为 ClickPipes 的第一大输入源,同时他们也在大力推进深度 Iceberg 集成。
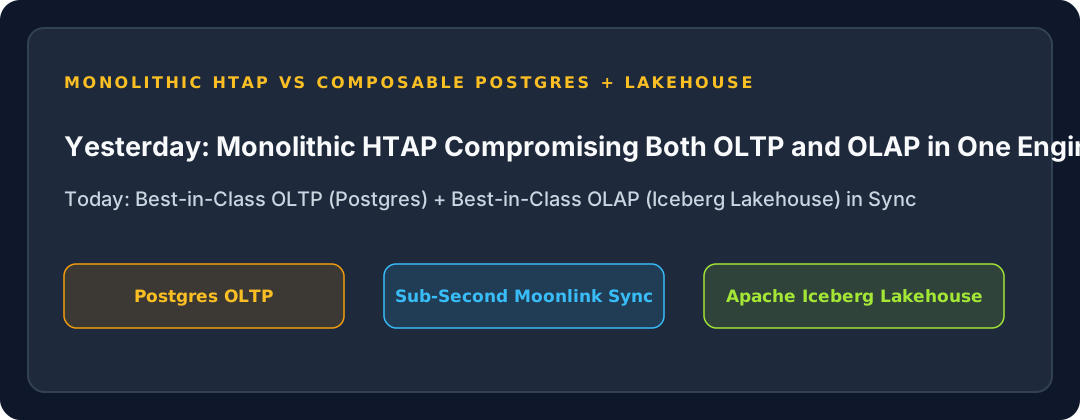
Postgres + Iceberg 是所有玩家共同押注的赛道。而决定胜负的关键,在于能否在这两者之间打造出极致的开发者体验——不再像传统单体 HTAP 数据库那样把分析强行塞进事务引擎而让双方同时妥协,而是让**最优秀的 OLTP(Postgres)与最优秀的 OLAP(Iceberg 湖仓)**各自独立发挥极致,又无缝协同得如同同一个系统。
Postgres + Lakehouse 永远属于开源社区
当巨头们先砸下数十亿美元买下一家 Postgres 公司、再试图把它粘进自家的商业湖仓护城河时,pg_mooncake 已经为你提供了亚秒级延迟的 Postgres 到 Iceberg 实时同步——而且采用 MIT 开源许可,完全免费 🙂
1.6 - HTAP 已死,精神长存
本文的灵感源自 Jordan Tigani 的经典博文《Big Data is Dead(大数据已死)》。事实上,Jordan 和我曾一起在 SingleStore 共事,联手打造过一套 HTAP 数据库。
黄金年代(1980 年代)
回到 80 年代,一套关系型数据库包揽了一切:白天跑在线事务(OLTP),下班后跑分析报表(OLAP)。像 Oracle V2 和 IBM DB2 这样的系统在同一台机器上同时承载 OLTP 和 OLAP——主要是因为当时的数据集还能装进几块磁盘里,而且计算硬件极其昂贵。
那时候没人把这叫做“混合事务/分析处理(HTAP)”,它就叫数据库(Database)。
大分裂(1990 年代)
随着企业数据量暴增、分析问题越来越复杂,单一数据库开始捉襟见肘。
事务型负载与分析型负载在物理资源诉求上背道而驰:OLTP 需要微秒级单行写入与点查,而 OLAP 需要全表扫描与大规模聚合。两者在同一个实例里不断发生资源争抢——大查询吞噬了延迟敏感型事务所需的磁盘 I/O 与缓冲池缓存,反之亦然。
怎么解决?把两类负载彻底拆开。到 2000 年代初,数据库领域的“大分裂”正式拉开帷幕。
存储层的分野(2000 年代)
推动这场分裂的核心技术驱动力是存储引擎架构:OLTP 系统针对行式存储(Row-Based Storage)做极致优化以加速写入与点查;而 OLAP 系统则转向列式存储(Columnar Storage)以实现高速扫描与聚合压缩。
到 2000 年代中期,这种行/列分治已成为行业标准。图灵奖得主、数据库先驱 Michael Stonebraker 在其著名论文《“One Size Fits All”: An Idea Whose Time Has Come and Gone》中为这一时代变革定下了基调——数据库开始裂变为各种专用引擎。
OLTP 与 OLAP 双双抛弃 SQL(2000–2010 年代)
水平扩展(Scale-Out)的需求把 OLTP 与 OLAP 推得更远了。
早期的分布式 OLTP 数据库(如 MongoDB 等 NoSQL 引擎)彻底抛弃了 SQL 和分析能力;而在分析领域,MapReduce 与 Hadoop/HDFS 数据湖架构席卷业界——用牺牲传统 RDBMS 严格一致性与 SQL 体验的代价,换取海量吞吐。
意料之外的殊途同归(2010 年代)
进入 2010 年代,两股数据库思潮同时兴起:
- NewSQL(Spanner、CockroachDB、Vitess):分布式 OLTP 依然应当构建在 SQL 与强一致性之上;
- 云数据仓库(Redshift、Snowflake):大规模 OLAP 同样应当回归具备事务保证的 SQL 系统。
表面上看,这两类系统服务于截然不同的负载;但在底层引擎上,它们却惊人地趋同:分布式架构、MPP 并行执行以及标准 SQL。孤立演进的 OLTP 与 OLAP 系统在几乎所有架构原则上都重新交汇了——只剩下一个核心差异:存储引擎。
于是我们不禁自问:如果能把行存引擎与列存引擎融合进同一个数据库里呢?
Voilà,HTAP 诞生(2014)
2014 年,Gartner 正式提出了 HTAP(Hybrid Transactional and Analytical Processing,混合事务/分析处理) 这一术语,将其视为下一代数据库架构的皇冠。
HTAP 的目标是弥合操作型系统与分析型系统之间的鸿沟,满足实时定价、反欺诈、个性化推荐等新兴场景的需求。早期的 HTAP 系统证明了这一构想在技术上的可行性:
- SingleStoreDB 将内存行存(Rowstore)、磁盘列存(Columnstore)与向量化执行引擎融为一体,在单个系统内同时支持高速扫描、点查、过滤、聚合与高频更新。
- TiDB 走了另一条路线:将基于行存的 TiKV 与基于 ClickHouse 演进的独立列存引擎(TiFlash)配对,通过维护两份数据副本来同时服务两类负载。
按理说,这应该就是终局了吧?重返 80 年代“一套数据库搞定一切”的极乐世界?然而现实并非如此。
2020 年代唯一的赢家是云数据仓库
云数据仓库毫无疑问赢下了市场。NewSQL 运动陷入停滞……而 HTAP 呢?它从未获得与其技术难度相匹配的市场普及度。尽管在内核工程上取得了实质性突破,单体 HTAP 数据库在商业上始终未能真正跨越 PMF(产品市场契合点)。原因有四:
1. 替换企业现有的核心 OLTP 系统难如登天。 看看 DB-Engines 排行榜就知道了:Oracle 和 SQL Server 至今仍稳居前三位。
2. 绝大多数业务根本不需要分布式 OLTP。 现代硬件越来越快、越来越便宜,一台高配单机实例足以扛住绝大多数公司的全部事务负载——就连 Cursor 和 OpenAI 的核心业务也是跑在单主架构的 PostgreSQL 实例上的。
3. 云原生架构青睐存算分离(Shared-Disk),而非无共享(Shared-Nothing)。 分布式 NewSQL 依赖昂贵的本地 NVMe 甚至内存持久化,而云平台的演进方向则是廉价对象存储加弹性无状态计算。
4. OLTP 与 OLAP 归属于不同的部门与团队。 OLTP 归业务研发团队管,OLAP 归数据平台团队管。两边的 KPI 与激励机制极少对齐——没有任何人会因为“把两套数据库合并成一套”而获得晋升。
今天:你的整个现代数据栈共同构成了“解耦式 HTAP 数据库”
云时代推动数据架构从紧耦合的单体仓库走向基于对象存储的模块化数据湖仓。数据团队开始用各个领域的“最佳组件(Best-in-Class)”拼装出自己的系统:
- OLTP 数据库与流处理系统充当系统的 WAL(预写日志);
- Apache Iceberg 等开放表格式充当底层的列式存储引擎;
- Spark、Trino、DuckDB 等计算引擎充当查询执行器;
- ClickHouse 或 Elasticsearch 等实时系统充当面向特定查询的二级索引。
即便在今天这套高度解耦的数据栈中,用户的核心诉求依然从未改变:在最新鲜的事务数据上跑极速 OLAP 分析查询。
这依然是 HTAP——只不过它是通过开放组件的组合(Composition),而非**单体数据库的吞并(Consolidation)**来实现的。今天的核心命题变成了:
1. 我该如何把 WAL 高效应用到开放存储引擎上? 换言之:如何以亚秒级延迟、极低写放大地将 OLTP 数据库的变更(CDC)同步进 Iceberg 数据湖?
2. 我能否在数据湖之上直接构建低成本索引并保持实时同步? 换言之:如何让数据湖具备实时写入能力,并直接通过 Postgres 或搜索引擎的接口查询湖中的数据?
我们这个时代的 HTAP 挑战,归根结底就是让数据湖仓(Lakehouse)真正具备实时能力(Real-Time Ready)。
在我把人生最宝贵的十年献给创建和拯救 HTAP 数据库之后,我可以坦然地说:作为单体数据库的 HTAP 已经死了;但 HTAP 的精神,正在实时数据湖仓中获得新生。 🥮
1.7 - “在 Postgres 中做分析”究竟意味着什么?
当今数据库领域很少有方向比“扩展 Postgres 以支持分析查询”更炙手可热了。这其实也算不上什么全新的课题——在过去十年间,业界已经有过许多次尝试:
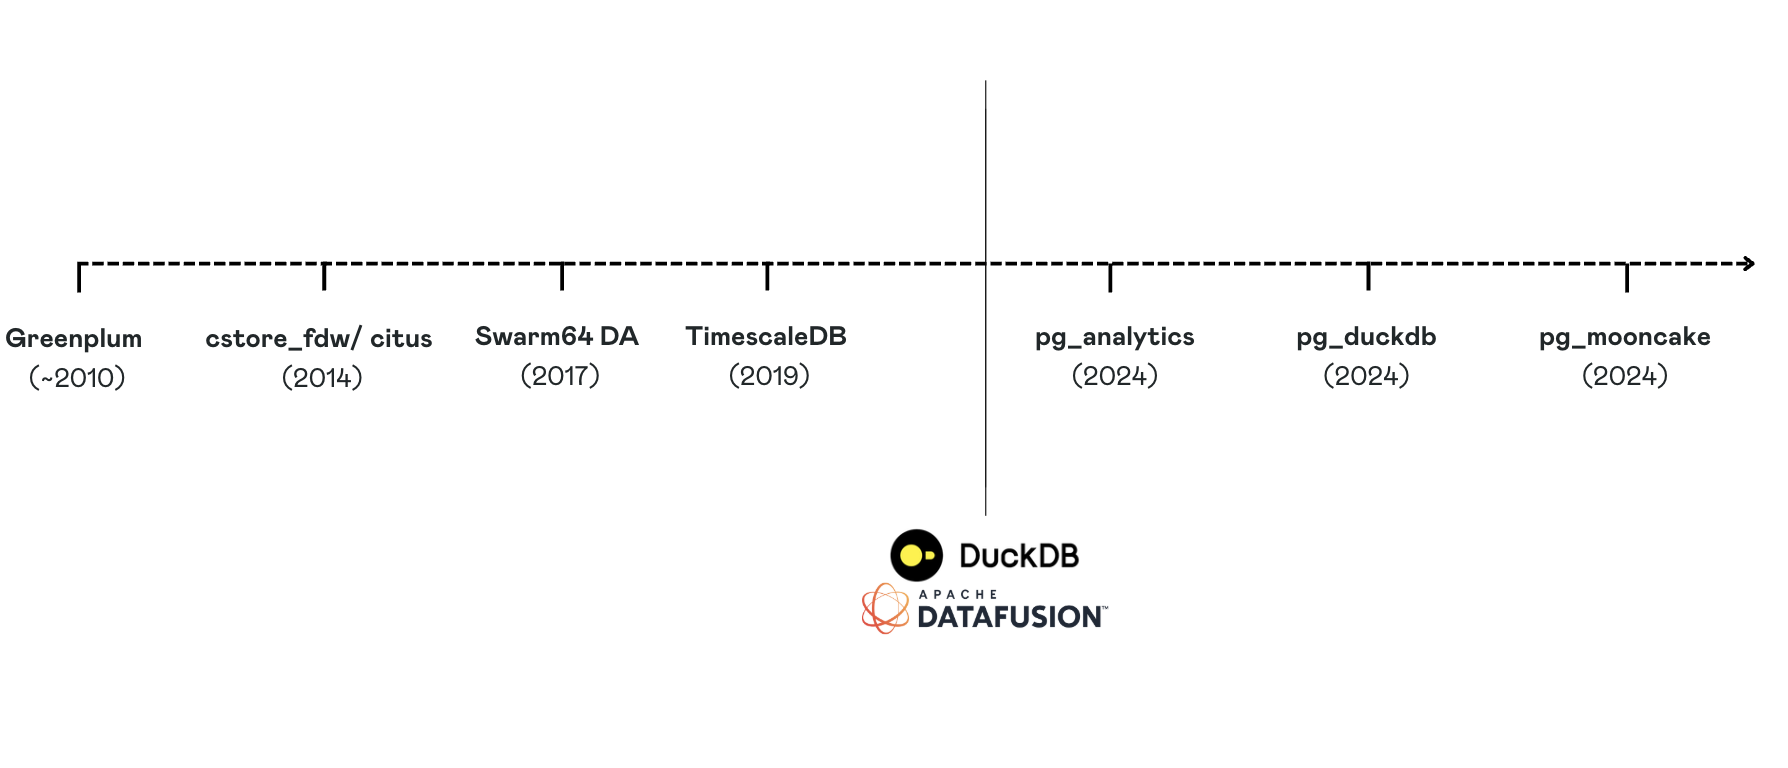
以下是我与大量客户交流后的核心总结——“Postgres 分析”对用户而言究竟意味着什么?以及为什么尽管我们在 pg_mooncake 第一阶段取得了一定成果,这个领域的终极难题在很长时间里依然悬而未决?
Level 0:直接在现有 Postgres 堆表上跑分析查询
只要配合合理的索引、统计信息、查询调优与物化视图,原生 Postgres 能够支撑的分析规模其实远超许多人的想象——很多团队在这件事上过度焦虑了。
然而,随着数据量与查询复杂度的持续增长,这套体系终究会触及天花板:过多的索引严重拖慢写入吞吐,物化视图刷新跟不上数据变化,某些大宽表聚合查询慢到无法忍受。
最终,你不可避免地会走到那个临界点:你必须把数据存成列式格式(Columnar Format)。
Level 1:我希望用 psql 直接查询外部列存数据
这一诉求在产品工程师中极具共鸣,因为它能大幅简化技术栈:开发者可以继续使用熟悉的客户端与已经配好的 ORM,还能在 Postgres 内部将分析表与业务表直接关联(JOIN)。这一层主要有两大流派:
1. pg_duckdb(在 Postgres 进程内嵌入 DuckDB)
利用内嵌的 DuckDB 向量化引擎直接查询外部列存文件(Parquet、CSV 等),并将结果流式返回给 Postgres。
2. Postgres FDW(例如 ClickHouse FDW)
从 Postgres 发起对 ClickHouse 表的查询,但查询计算本身在外部 ClickHouse 集群中执行。
无论哪种方式,查询都由向量化引擎执行,核心区别仅在于分析计算发生在你的 Postgres 实例内部还是外部计算集群上。但这两者都有一个隐含前提:你的数据已经以列存格式(如 Parquet 文件或 ClickHouse 表)存在了。
剧透一下:现实中你的数据并没有。
Level 2:我希望直接用 Postgres 写入并管理列存数据
与其搭建一套繁琐的 ETL 工具并引入一个独立的专用分析数据库作为终点,我只希望一切都在 Postgres 里搞定。
这正是我们在 pg_mooncake v0.1 中通过引入原生列存表所解决的问题:你可以像操作普通 Postgres 表一样,在列存表上创建并执行事务性的写入、删除与更新,而查询则由 DuckDB 极速执行。CMU Andy Pavlo 教授在 2024 数据库年度回顾中也重点提到了我们的这一创新。
这一思路与 Crunchy Data Warehouse 类似:两者都采用开放数据格式(Iceberg、Delta Lake、Parquet)作为底层列式存储,在避免任何数据供应商锁定的同时提供顶尖性能(ClickBench 全球前十)。
我们对 pg_mooncake 的首个正式版本(v0.1)非常满意。但很快我们发现,这还远远不够。
Level 3:我需要列存表与我的 Postgres 业务堆表保持实时同步
这里的真实用户故事是:“我的线上应用每秒都在发生各种 INSERT、UPDATE 和 DELETE,而我需要在最新鲜的数据上直接提供面向用户的实时分析。” 这种需求在应用内嵌分析(User-Facing Analytics)场景中比比皆是。目前业界主要有两条路线:
1. 在 Postgres 里造一个无所不能的“全功能事务型列存表”。
让一张列存表同时完美支持高并发 ACID 事务、二级索引、频繁更新与删除、预编译语句、触发器以及任意形态的查询——听起来像魔法,但在理论上是可行的。
当年在 SingleStore,我们花了整整十年时间打造了一套以列存作为单一事实来源(Source of Truth)的 HTAP 数据库。但残酷的现实是:即便投入了十年心血,它在纯正 OLTP 场景下依然不够完美。
我们最初也曾设想让 pg_mooncake 的列存表在 Postgres 里走同样的路,但很快就意识到:以扩展形式重造整套 OLTP 能力无异于同 Postgres 自身正面竞争——Postgres 原生堆表经过三十余年的千锤百炼,围绕它构建的特性与扩展生态实在太强大了(参见我们在 Hacker News 上的深度讨论)。
2. 将 Postgres 表通过 CDC 复制到外部专用分析系统。
典型代表如 ClickPipes + ClickHouse。
Postgres 在 WAL 层面提供了极其稳健高效的逻辑复制(CDC)机制。对于纯追加(Append-Only)场景,ClickHouse 可以通过内存缓冲并定期刷盘来轻松应对。
但一旦遇到高并发的 UPDATE 与 DELETE,问题就棘手了:ClickHouse 会在底层存储同一行数据的多个历史版本(或使用 ReplacingMergeTree),并把后台合并前的去重逻辑(如 FINAL 查询开销或自定义去重 SQL)甩给业务开发者自己处理。祝你好运。
你真正需要的,是一个能跟上 Postgres OLTP 高频更新的实时列存镜像引擎
仔细想想,这是一个近乎疯狂的工程需求:底层是磁盘或对象存储上一系列不可变(Immutable)的开放格式 Parquet/Iceberg 文件,顶层却要实时吸收高并发 OLTP 堆表的增删改流,并且还要在 Postgres 内部直接管理与强一致查询!
而这,正是我们在 pg_mooncake v0.2 / v0.3 中通过 Moonlink 实时存储引擎彻底攻克的核心难题。🥮⭐
1.8 - 如何让 DuckDB 在 Parquet 文件上的查询性能再上一个台阶
上周,我们在 PostgreSQL 上运行了 ClickBench 基准测试并成功闯入全球前十,证明了通过 pg_mooncake 扩展,Postgres 完全能够胜任严肃的大规模分析负载。
在成绩公布后,我们收到了许多开发者的提问:既然 pg_mooncake 内部嵌入了 DuckDB 并将数据存储为 Parquet 格式,为什么它在 Parquet 文件上的查询速度反而比直接使用 DuckDB 扫描还要快?
最酷的地方在于:pg_mooncake 甚至一行 DuckDB 内核代码都没有修改……
快速回顾 pg_mooncake 的架构设计
pg_mooncake 是一个为 Postgres 增加列式存储与向量化执行的扩展:
- 列存表中的数据存储在 Parquet 文件中;
- 表的元数据(当前有效快照包含哪些 Parquet 文件)存储在 Postgres 内部并具备事务一致性保证;
- 针对列存表的查询交由内嵌的 DuckDB 引擎执行。
建议先阅读我们的完整架构解析。
“大象”是如何跑赢“鸭子”的?
乍看之下,一个把 Postgres 查询通过 pg_duckdb 路由给 DuckDB 去扫描 Parquet 文件的系统,似乎不可能比 DuckDB 直接扫描那些 Parquet 文件更快。
在 ClickBench 榜单上,普通包装器确实存在明显开销:pg_duckdb(10.21x) 相比 DuckDB (Parquet, partitioned)(6.76x) 有着不小的性能损耗。
然而令人惊讶的是,尽管底层同样依赖 pg_duckdb,pg_mooncake(6.03x) 不仅比 pg_duckdb 快了约 1.5 倍,甚至反超了原生 DuckDB (Parquet, partitioned) 本身!
为什么 pg_mooncake 能跑赢原生 DuckDB Parquet?
首先,pg_mooncake 直接利用 Postgres 存储表元数据,省去了像外部 Iceberg 或 Delta Lake 表那样访问外部 Catalog 并解析多层清单文件的开销,能够直接定位当前快照需要扫描的 Parquet 文件集合。
更重要的是,pg_mooncake 将每个 Parquet 文件的详细元数据(包括每个行组 Row Group 的列级统计信息,如每列的 MIN / MAX 值)预先提取并维护在 Postgres(以及 v0.2 / v0.3 的 Moonlink 元数据层)中。当查询列存表时,pg_mooncake 会利用这些统计信息在扫描前直接裁剪掉不可能包含匹配行的数据文件与行组(Segment Elimination)。
例如,对于下面这样的查询:
任何 order_date 范围落在该区间之外的文件和行组都会被直接跳过。通过避免不必要的磁盘与对象存储 I/O,查询性能得到了大幅提升。
此外,由于反序列化和解析 Parquet Footer 元数据本身具有一定 CPU 开销,pg_mooncake 还在内存中维护了 Parquet 元数据缓存,从而额外带来了约 5% 的查询加速。
为什么依然坚持使用 Parquet?
我们也经常被问到这个问题:如果只追求单机极限性能,设计一种私有的内存/磁盘列存格式无疑能榨干最后一滴性能。
但我们始终坚信湖仓一体(Lakehouse)架构所带来的开放性价值。Postgres 并非为了独自包揽数据生命周期的每一个环节而设计,而采用标准 Parquet + Iceberg 格式能够实现无缝的多引擎互操作。
最重要的是,我们已经用实测数据证明:即便坚持使用 Postgres 与开放的 Parquet 格式,你依然能够获得世界顶级的分析性能。
DuckDB 与 pg_mooncake 还有巨大的优化空间
在运行 ClickBench 的过程中,我们还梳理出了针对 DuckDB 与 pg_mooncake 的一系列后续优化点。我们非常期待与社区一起推进这些优化,将其回馈至 DuckDB 上游或以 DuckDB OptimizerExtension 的形式实现,让开放格式上的分析查询越来越快。
🥮
1.9 - ClickBench 基准测试证明:Postgres 是一流的分析型数据库
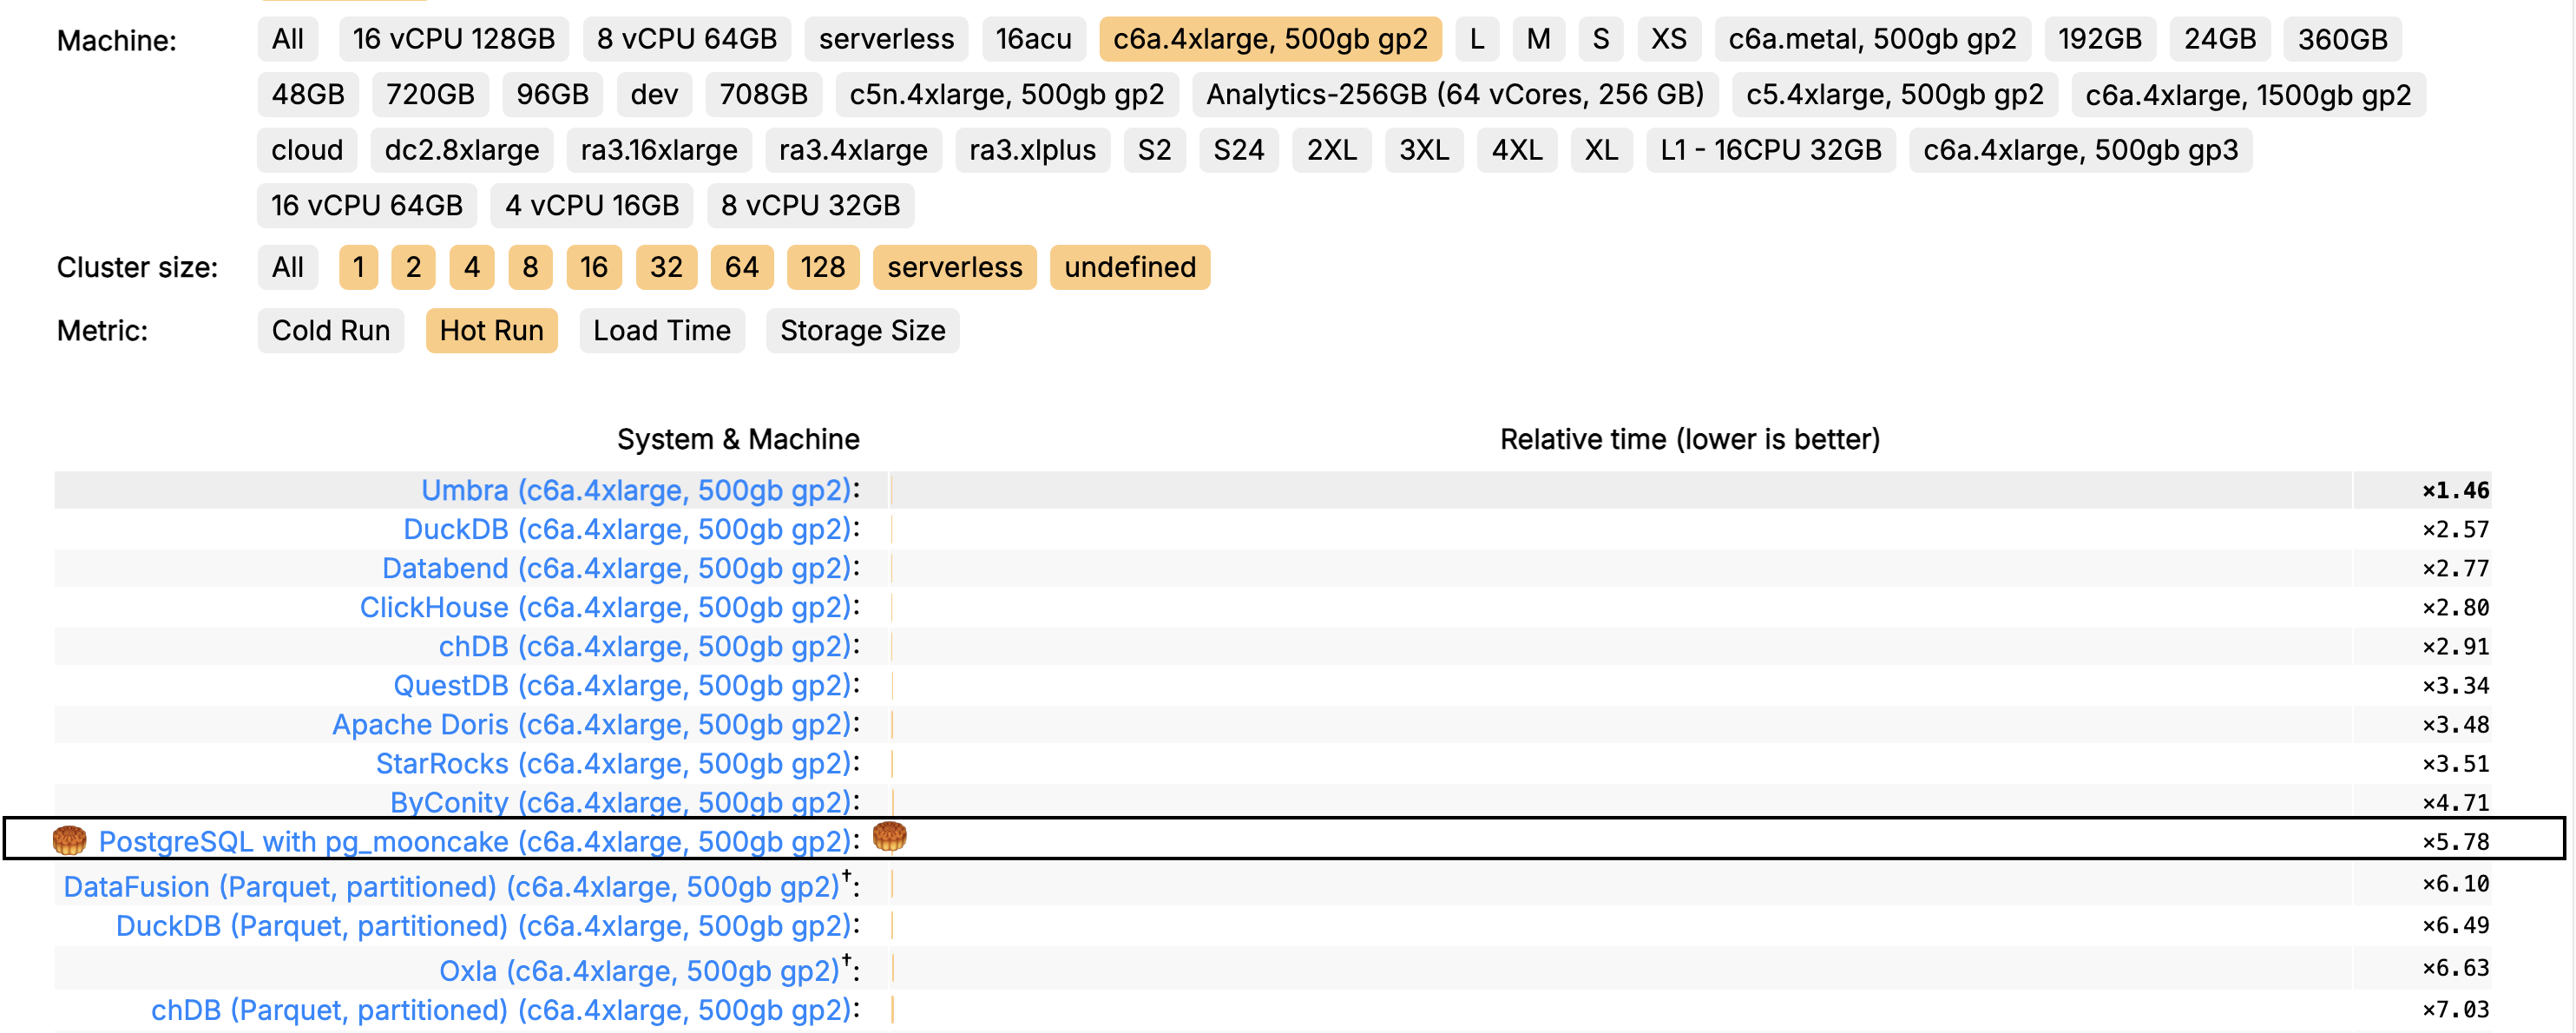
太长不看版(TL;DR): 经过几个月的深度优化,我们让 PostgreSQL 成功闯入了 ClickBench 全球前十——这个榜单长期以来一直被各种专门构建的 OLAP 分析数据库所统治。
更重要的是,所有计算均在 Postgres 进程内完成,所有表均由 PostgreSQL 直接管理——它绝不是一个简单的外部代理包装器。这就是 pg_mooncake 的故事。
什么是 ClickBench?
ClickBench 是实时分析型数据库领域最权威的基准测试,最初由 ClickHouse 团队发起,旨在评估数据库处理真实世界大规模表扫描、多维过滤与复杂聚合查询的能力。
在历史上,ClickHouse 等专用分析型数据库一直在该榜单上遥遥领先,而像 Postgres / MySQL 这样的通用关系型数据库往往慢上 100 倍以上。我们希望打破这一固有印象——而 Postgres 不负众望。
如何在 Postgres 内部构建极速分析引擎?
当大多数人想到 PostgreSQL 时,脑海里浮现的是一台坚如磐石的 OLTP 事务数据库,而不是实时分析引擎。然而,PostgreSQL 无与伦比的可扩展性使它具备了越级挑战的能力。
以下是我们的核心工程路径:
1. 构建原生 PG 扩展
我们充分利用 PostgreSQL 的扩展机制,将 pg_mooncake 构建为原生的 PG 扩展。
2. 存储格式:列式存储(Columnstore)
对于分析型负载而言,列存格式不可或缺。ClickBench 的典型负载是一张极宽的大表,而每条查询通常只访问其中少数几列:
- 在行存表(如 PostgreSQL 原生堆表)中,读取单列意味着必须在磁盘页面上跨行跳跃读取;
- 在列存表中,同一列的数据连续存放,顺序读取极快,且能实现更高的压缩率以及直接在压缩数据上执行计算。
3. 向量化执行(Vectorized Execution)
为了彻底释放列存格式的计算潜力,我们将 DuckDB 嵌入作为列存查询的执行引擎。整个执行管线以向量化批次(Vectorized Batches)而非逐行(Tuple-at-a-time)方式处理数据,充分激活现代 CPU 的 SIMD 指令集,在全表扫描、GROUP BY 分组与聚合计算中展现出极高的吞吐效率。
4. 在 PostgreSQL 内部直接管理表元数据与统计信息
在实时分析中,固定开销与规划延迟至关重要。我们没有在每次查询时去对象存储或 Parquet 文件尾部解析元数据,而是将文件列表与行组(Row Group)统计信息直接持久化在 PostgreSQL 中:
- 大幅缩短查询规划(Query Planning)耗时;
- 支持精细化的文件跳过(File Skipping)与行组裁剪,显著减少不必要的 I/O(详见下一篇深度解析)。
关于整体架构的更多细节,请参阅《pg_mooncake 是如何构建的》。
这意味着什么?
PostgreSQL 不再仅仅是一匹 OLTP 驮马。通过精心的内核工程与架构调优,它完全能够在保留 PostgreSQL 完整生态与灵活性的同时,提供媲美专用 OLAP 数据库的分析性能。
在打造了十年高端数据系统之后,我最核心的信念之一便是:我们可以把现代数据栈变得简单得多。
pg_mooncake 采用 MIT 开源许可证发布,欢迎立即上手体验。
🥮
1.10 - S3 Tables 究竟是个啥?
亚马逊在去年的 re:Invent 大会上发布了 S3 Table Buckets(S3 表存储桶)。一个既是 S3 存储桶、同时又是一张数据库表的东西?这到底是什么意思?
太长不看版(TL;DR): S3 Tables 让 Apache Iceberg 表可以脱离外部 Catalog(目录服务)独立存在。下面听我详细拆解。
Iceberg vs Delta Lake
等等,Iceberg 和 Delta Lake 不都是开放表格式吗?为什么要比较它们的底层元数据实现方式?
原因在于,由于元数据设计的根本差异,Iceberg 与 Delta Lake 之间有一个至关重要的区别:“Delta 表可以脱离 Catalog 独立存在,而 Iceberg 表不行”:
1. Delta Lake 依赖底层文件系统在元数据层实现 ACID。
_delta_log 目录中的元数据层本质上是一个不断追加的 JSON 文件有序列表。只要一个目录下包含 Delta 表,你只需要按照文件名顺序逐个读取 _delta_log 中的文件,就能还原出整张表的当前状态。
你不需要任何额外信息或外部“Catalog”就能直接读写 Delta 表。
2. 相反,Iceberg 与存储层解耦,依赖外部 Catalog 来实现 ACID。
Iceberg 的元数据层是一个由快照节点(Snapshot Nodes)构成的反向链表(从 SNAPSHOT N+1 可以找到 SNAPSHOT N,但反过来不行)。
因此,你必须依赖一个外部“Catalog”来原子性地写入并获取最新快照指针(Metadata Location)。
那么问题来了:如果底层对象存储系统自己就能一致地“记住”当前快照指针,并提供原子交换(Atomic Swap)接口呢?Bingo,这就是 S3 Table Bucket!
向 S3 Table Buckets 写入数据究竟是如何工作的?
我花了不少时间啃完了 S3 Tables 官方文档,这样你就不用再去受罪了(顺便吐槽一句,这文档写得极其晦涩,连 DeepSeek 读起来都费劲)。
我们来对比一下向“普通 Iceberg Catalog”与向“S3 Table”写入数据的流程差异:
- [两者相同] 计算引擎写入数据文件(Parquet)
- [两者相同] 计算引擎写入 Iceberg 元数据文件(Manifest / Metadata JSON)
- [仅普通 Catalog] 请求外部 Catalog 提交新快照
- [仅 S3 Table] 调用 S3 API
update-table-metadata-location完成原子提交
没错,这就是唯一的区别。
那么 S3 Tables 的核心优势是什么?
我确信亚马逊在底层性能(包括自动 Compaction 和存储桶物理布局)上做了大量优化工作。
但在功能语义上,最核心的区别在于:
S3 Tables 允许你按路径读写存储桶中的任意文件,但禁止执行 LIST(列举文件)操作。
第一眼看到这个限制时我觉得很蠢,但仔细一想却非常精妙:
这意味着“探测”一个表存储桶的唯一途径,就是先读取该存储桶维护的 metadata-location 元数据指针。因此在设计上,任何用户都只能读取属于当前有效表快照的数据文件,因为你根本没有办法通过列举目录去发现任何其他孤儿文件或未提交文件。
谁最适合使用 S3 Tables?
我认为它的真正用武之地可能和大多数人想的完全不同。
对于超大规模企业级湖仓(Enterprise Lakehouse)而言,维护一套集中式的外部 Catalog(如 Unity Catalog、Polaris)和统一的表维护服务本来就是顺理成章的事;更何况 S3 Tables 的单价依然比普通 S3 贵不少。因此我并不认为大型企业湖仓会是它的主力场景。
在我看来,S3 Tables 最适合中小规模团队与轻量级分析场景,尤其是嵌入到现有应用工作流中——它让你无需运维任何外部 Catalog 就能直接用上标准的 Iceberg 表。
最后给出我的一个预言:第一个支持写入 S3 Tables 的计算引擎是 Spark,而第二个将会是 Postgres。
🥮
1.11 - pg_mooncake 🤝 Drizzle:用强类型 ORM 驱动分析查询
在 pg_mooncake 发布之初,有一件事出乎我们的意料:开发者们非常关心能否在分析型负载中继续使用熟悉的 ORM。我们经常收到两类典型需求:
- “我手头有一堆 Parquet 文件,我希望能在它们之上获得完整的 ORM 类型支持。”
- “我在事务数据库里用了 Drizzle / Prisma,我也希望能直接用它来写分析报表和仪表盘查询。”
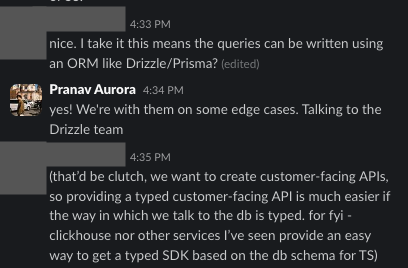
我们始终坚信,Postgres 中的列式存储在外观和使用体验上必须像一张普通堆表。这正是 pg_mooncake 列存表的核心创新所在:你可以对它执行事务、更新、删除,并与普通堆表直接关联(JOIN)。
在 Postgres 中提供原生列存表的一大额外红利在于:你最喜爱的 ORM 可以直接开箱即用。在本文中,我们将使用 Drizzle ORM 来演示这一点。
下面让我们基于一份 Reddit 评论数据集构建一个简单的分析应用,并全部使用 Drizzle 编写分析查询。
1. 创建 pg_mooncake 列存表
我们将使用来自 Hugging Face 的 Reddit 评论数据集。首先创建一张 pg_mooncake 列存表(参见 v0.1 数据导入语法 与 v0.3 mooncake.create_table 参考):
接着,将 Hugging Face 上的 Parquet 数据直接复制到 reddit_comments 表中(这里我们导入单个包含 1500 万行的 Parquet 文件):
非常棒!现在从 Hugging Face 往 Postgres 导入海量数据既简单又飞快。
2. 为列存表定义 Drizzle Schema
配置好连接 Postgres 实例的 Drizzle 驱动后,我们可以像定义普通表一样为列存表编写 Schema:
3. 以完整的类型安全查询数据模型
例如,按板块聚合统计评论数与平均得分:
你可以用自己最熟悉的 TypeScript 语法编写极速分析查询。
4. 立即开始使用 pg_mooncake
欢迎了解我们在 Drizzle 的伙伴们——用 ORM 驱动分析查询从未如此轻松。我们现已成为 Drizzle 的官方赞助商:
我们非常期待与社区一起推进诸如 One Dollar Stats 这样的项目,敬请期待更多精彩内容。
1.12 - pg_mooncake + Neon:PostgreSQL 中的 Serverless 实时分析
pg_mooncake 在两个月前发布了 Beta 版,为 PostgreSQL 带来了列式存储与向量化查询执行引擎。
在过去两个月与早期用户的打磨过程中,我们突然意识到:我们无意间打造出了最优秀的 Serverless 分析数据库。故事是这样的:
1. pg_mooncake 🤝 Neon 存储引擎
Neon 在其底层存储引擎上做出了重大创新(推荐阅读 Nikita 关于这一架构的技术长帖)。正是依靠这套存储引擎,Neon 实现了真正的存算分离,进而带来了数据库分支(Branching)、缩容至零(Scale-to-Zero)、秒级只读副本与即时实例拉起等极致的 Serverless Postgres 开发者体验。
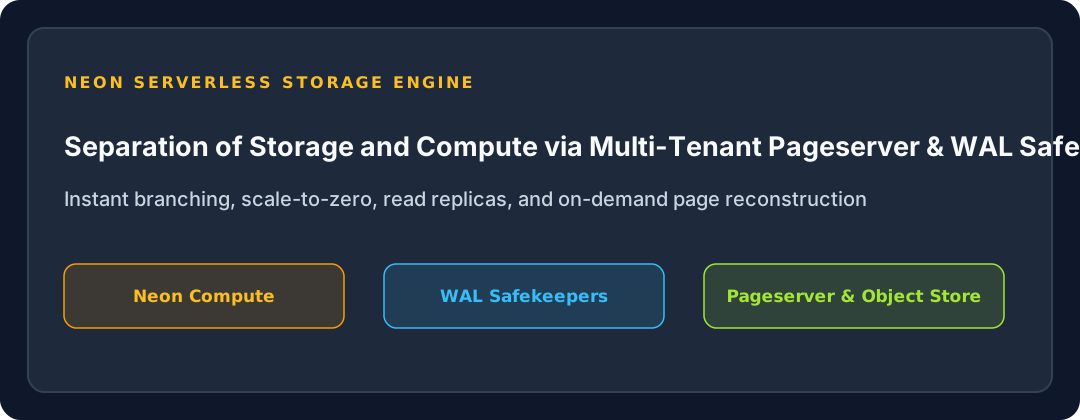
与此同时,pg_mooncake 的架构同样基于真正的存算分离:列存数据以 Parquet 格式存放在对象存储(或本地文件系统)中,而 Postgres 内部仅保存轻量级元数据。
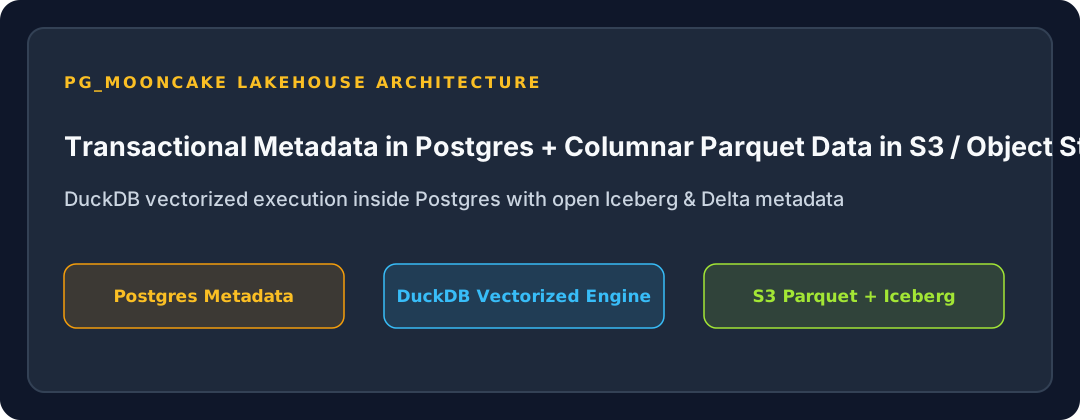
这正是经典的湖仓一体(Lakehouse)架构——全球规模最大的科技公司正是利用这种架构,以高性价比、Serverless 的方式存储并分析海量数据的。
一句话总结 Lakehouse:将所有数据以通用开放格式存放在对象存储中,随后通过 Pandas DataFrame、Spark 或 DuckDB 以无状态方式直接查询。
pg_mooncake 的目标,就是将这种灵活性、可扩展性与 Serverless 分析体验带给每一个 Postgres 应用。
2. 一切皆可缩容至零(Scale to Zero)
将 Neon 的存算分离存储与我们的分析架构结合在一起——你就能在同一个数据库体系内,同时为事务型(OLTP)与分析型(OLAP)负载实现彻底的存算分离,并且所有表元数据依然统一保存在 Postgres 中。
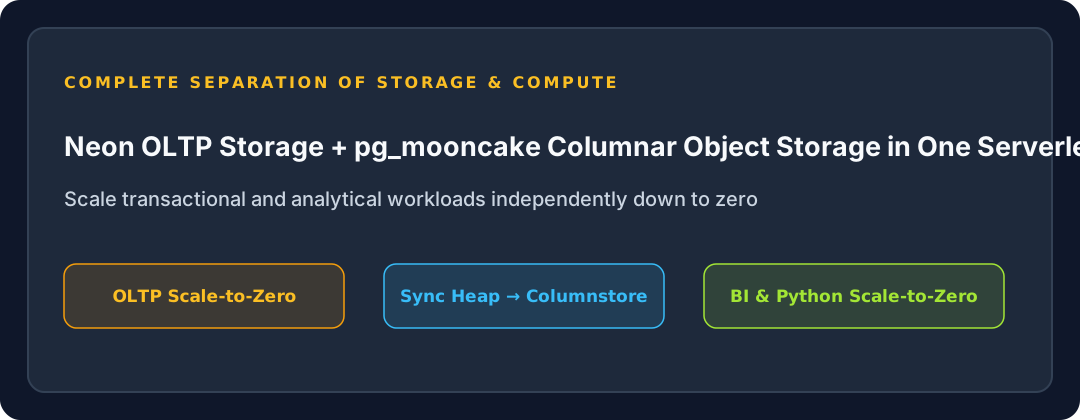
借助这套把分析表与事务表融为一体的 Serverless 架构,我们的用户实现了许多令人惊艳的用法:
- 将分析负载与事务负载完全隔离,并分别独立弹性扩缩容;
- 使用独立的计算节点将堆表(Heap Tables)的变更实时同步至列存表;
- 在 BI 报表与仪表盘查询中直接将列存表与堆表关联(JOIN);
- 运行在空闲时可自动缩容至零(Scale-to-Zero)的完整分析服务。
例如 Inkeep 团队完全基于 Postgres 交付了他们的核心应用、高速 BI 仪表盘以及分析报表服务。各个服务的计算资源独立扩缩,而全部数据与表元数据始终留在 Postgres 之中,极其干净利落。
3. 基于 Python 的 Scale-to-Zero 分析
更有趣的部分来了。
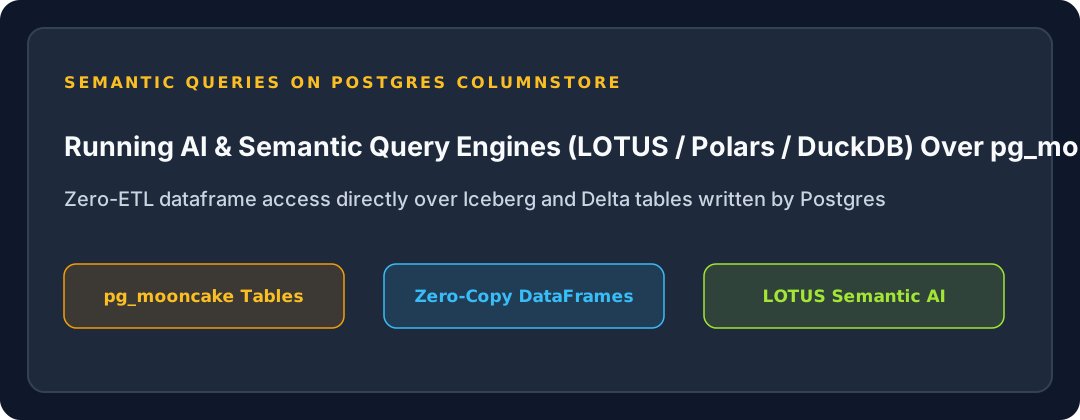
pg_mooncake 将数据以标准的开放分析格式(Apache Iceberg 与 Delta Lake)写入对象存储。这些元数据层覆盖在 Parquet 文件之上,使得任何查询引擎(Pandas、Polars、Spark、DuckDB)都能把对象存储上的文件当作一张完整的数据库表来直接读取。
我们看到许多 pg_mooncake 用户直接使用 Python 读取并转换列存表数据——从列存表构建 DataFrame 易如反掌(参见 云对象存储配置 与 Iceberg 对象存储参考)。
此外,还有用户在 Postgres 列存表之上直接运行诸如 LOTUS 这样的 AI 语义查询引擎:
4. 立即开始体验!
请阅读我们的快速开始指南,在 PostgreSQL 中创建你的第一张实时列存表。
1.13 - pg_mooncake:基于列存表与 DuckDB 的 Postgres 极速分析引擎
pg_mooncake 将列存表(Columnstore Tables)与 DuckDB 向量化执行引擎引入 PostgreSQL,以实现极速分析查询。
它像普通 Postgres 表一样支持事务性的 INSERT、UPDATE 和 DELETE。底层数据以 Parquet 文件配合 Delta Lake(以及 v0.2+ 中的 Apache Iceberg)表元数据写入,因此也可以在 Postgres 外部直接查询。
为什么还需要另一个 Postgres 分析扩展?
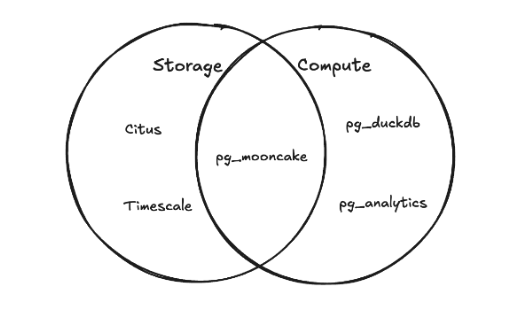
PostgreSQL 是当今最受欢迎的数据库,但它在分析型查询(OLAP)上的表现并不理想。业界曾有过许多尝试,但收效有限。极速分析需要一整套截然不同的底层技术,例如列式存储(Columnar Storage)、向量化执行(Vectorized Execution)和延迟物化(Late Materialization)。早期的 Citus 与 Timescale 等项目为 Postgres 添加了列式存储,但缺乏优秀的向量化执行引擎来充分发挥列存格式的威力。
如果在十年前,从头编写一套向量化执行引擎会是一个浩大的工程;但在今天,我们有了 DuckDB。
对于还不熟悉 DuckDB 的读者,可以将它理解为“分析领域的 SQLite”。它专为嵌入宿主进程而设计(在我们的场景下宿主就是 Postgres)。它的分析速度极快,在 ClickBench 基准测试中名列前茅;并且它的 SQL 语法与 Postgres 高度兼容,大大降低了集成难度。
近期我们看到将 DuckDB 嵌入 Postgres 的趋势正在兴起。像 pg_duckdb 和 pg_analytics 这样的扩展旨在从 Postgres 中查询外部列式存储,但它们无法通过事务性的 INSERT / UPDATE / DELETE 直接写出这些开放格式的数据。
pg_mooncake 则同时带来了支持事务读写的列存表以及能够充分利用该格式的向量化计算引擎。
pg_mooncake 是如何构建的
首先要做的决定是选择存储格式。虽然私有格式可以针对单一引擎做极致优化,但开放格式允许跨引擎共享数据——就像月饼生来就是为了与朋友分享一样。pg_mooncake 选择 Parquet 作为数据文件格式,并附上 Iceberg 与 Delta Lake 等开放表格式元数据,从而确保任何主流计算引擎都能直接读取 Mooncake 表。
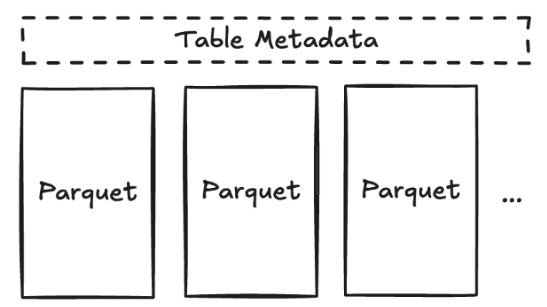
对表的操作可以视为对这些底层 Parquet 文件的操作:INSERT 与 COPY 会生成新的 Parquet 文件,UPDATE 与 DELETE 则会移除旧文件并生成包含修改的新文件(在后续的 v0.2 / v0.3 架构中,我们引入了基于 Puffin 的位置删除向量 Deletion Vectors,无需重写原文件即可标记删除行)。
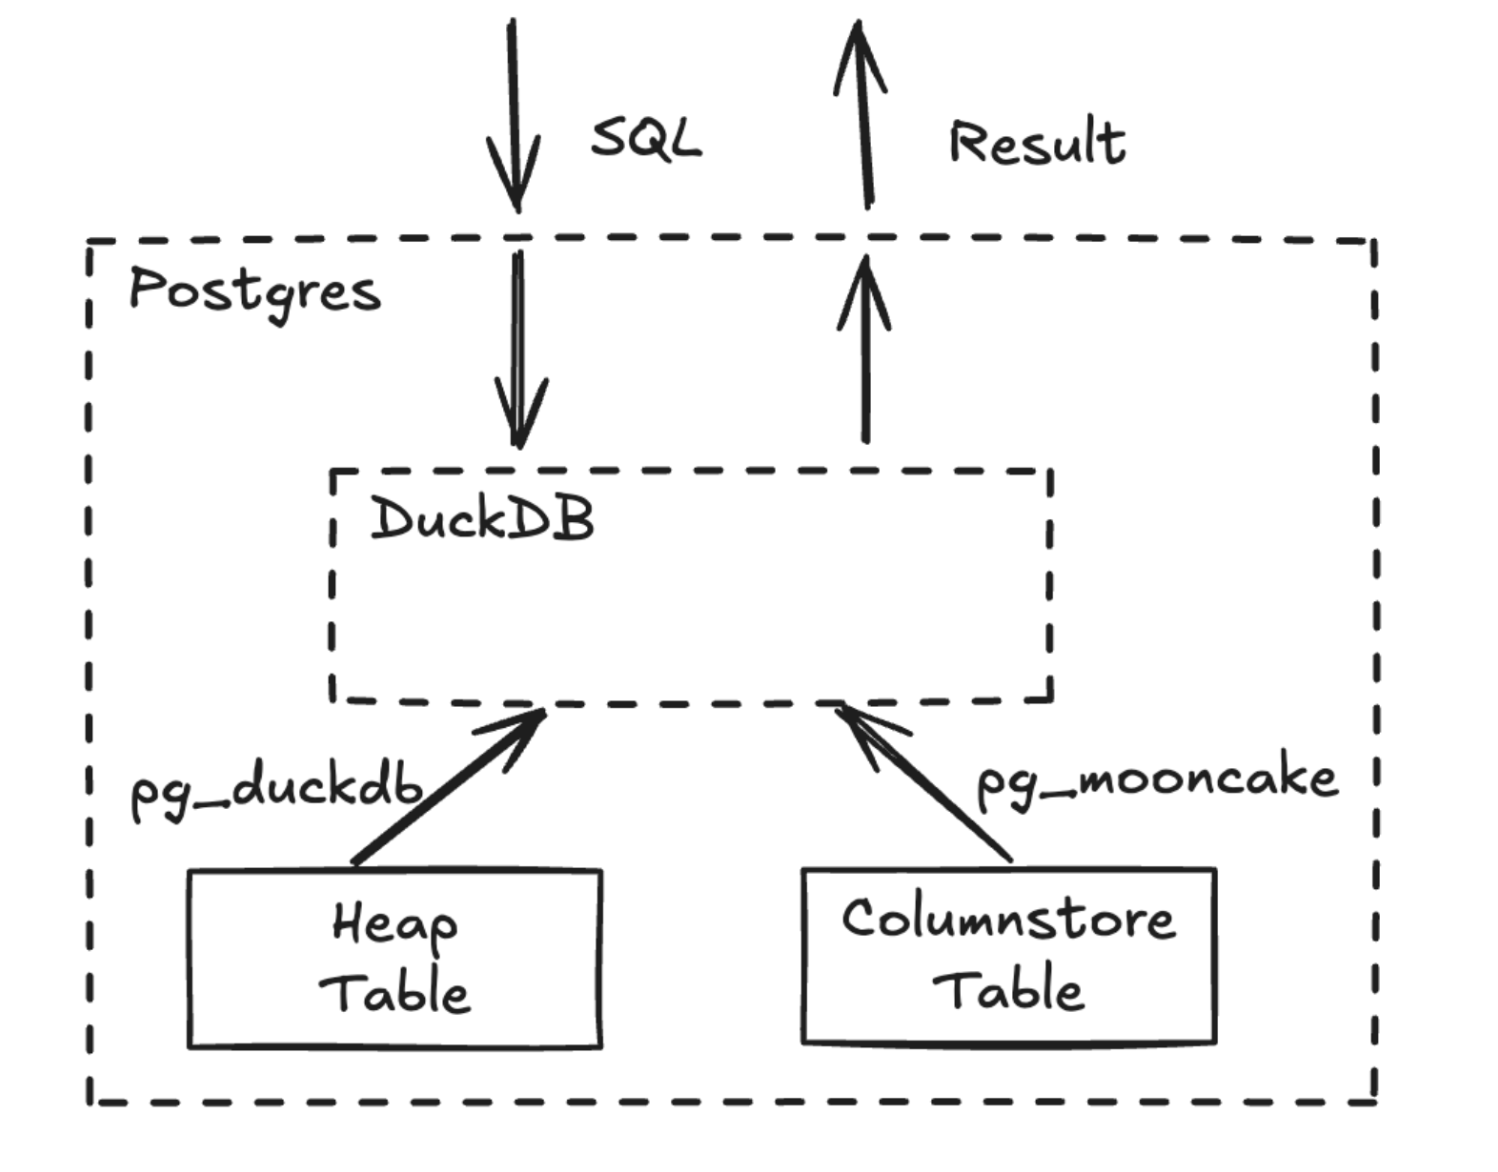
在底层核心上,pg_mooncake(v0.1)由两部分组成:Postgres 内部的列存表访问方法(TAM)接口 + DuckDB 内部的 Parquet 存储扩展(duckdb_mooncake)。表的元数据(包括 Parquet 文件的新增与删除记录)直接存储在 Postgres 系统表中以保证事务一致性。涉及列存表的查询会从 Postgres 路由至 DuckDB 执行,并将结果流式返回给 Postgres。
这种深度集成之所以成为可能,得益于 DuckDB 与 Postgres 极强的可扩展性——两者都允许开发者自定义存储层、查询规划器(Planner)和执行器(Executor)。
查询生命周期(Query Lifetime)
让我们来看看一条查询在 pg_mooncake 中的完整生命周期。
当一条 SQL 查询到达 Postgres 时,Postgres 先对其进行解析并生成查询计划。当检测到查询涉及列存表时,该查询会被识别为分析型查询,交由 DuckDB 全权执行,并将结果流式传回 Postgres,期间会自动完成细微的 SQL 语法改写。
我们在 DuckDB 中注册了自定义存储扩展(duckdb_mooncake),实现了 TableScan、Insert、Update、Delete 等物理算子。此外,由于 pg_duckdb 实现了对普通 Postgres 堆表的读取能力,我们的列存表可以在 DuckDB 引擎内部直接与普通 Postgres 表执行高速关联查询(JOIN)。
事务性更新与删除
为了支持 DELETE 与 UPDATE,TableScan 期间会填充一个隐式的 row_id 列,由 (file_id, row_offset) 组成,用于精确定位每一行。物理删除算子会记录所有被标记删除的 row_id,并在读取受影响的 Parquet 文件时过滤掉已删除行;物理更新算子则将更新后的行流式写入新 Parquet 文件,并标记旧行的 row_id 为已删除。
所有表元数据(包括 Parquet 文件的增删与统计信息)都保存在 Postgres 表中,从而天然具备 ACID 事务保证。DuckDB 在执行 SQL 查询时会获取对应的 Postgres 快照(Snapshot),并从该快照读取元数据以保证强一致性。
下一步计划
我们将持续打磨 pg_mooncake,使其真正达到生产级就绪状态。文件合并(Compaction)、二级索引与约束、分区表支持等功能均已在路线图中。
作为一家初创公司,Mooncake Labs 的目标是打造面向开发者的湖仓一体(Lakehouse)架构——用简洁的 Postgres 与 Python 接口彻底简化现代数据栈,而 pg_mooncake 正是迈向这一愿景的第一步。
🥮
1.14 - Mooncake:下一代搜索与分析系统
我们是 Zhou、Cheng 和 Pranav。过去十年里,我们一直在 MemSQL(现名 SingleStore)研发数据库内核。
我们热爱复杂系统、硬核工程技术,当然还有——物理学 🙂 数据系统就像物理学一样,建立在若干基本公理之上。这些原则必须自洽且持久。
仅仅打造一个“技术指标上更好”的系统是徒劳的。一个数据系统的成败取决于它所秉持的架构原则,而在中途改变基因几乎是不可能的:闭源商业公司不可能摇身一变成为真正受社区拥戴的开源项目;绑定了私有存储格式的数据库也不可能轻易放弃自己的存储引擎、蜕变为高效的无状态计算引擎。
对于数据领域正在发生的变革以及什么才是正确的方向,我们有着坚定的信念。这些原则共同构成了 Mooncake。
我们非常感激 Khosla Ventures、Nikita Shamgunov、Jordan Tigani、Barry McCardel、Amir Haghighat、Paul Copplestone、Roger Luo 以及众多伙伴的支持。感谢你们相信我们与我们的原则。
1. 现代软件是由“产品工程师”构建的
当今数据社区所构建的接口、行话与技术栈,与现代软件团队真正交付产品的方式之间,存在着巨大的鸿沟。而这正是我们的机会。如今的开发团队主要分为两类:
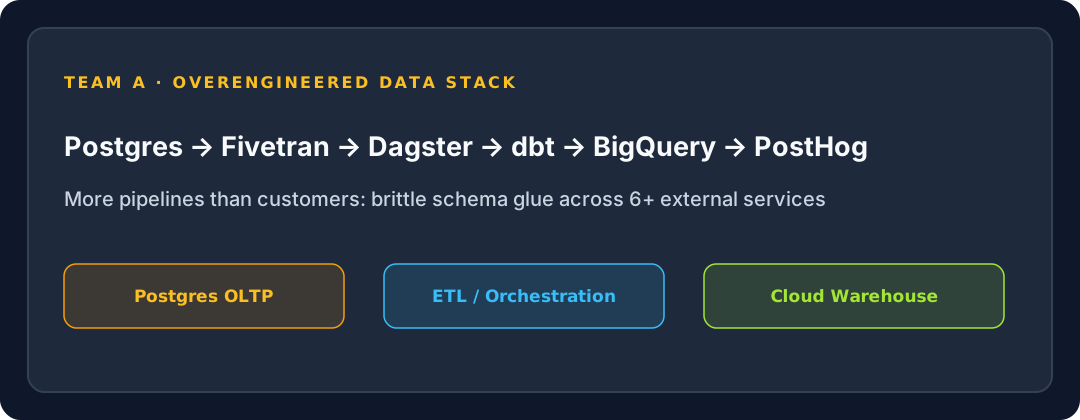
a. 过度工程化的团队(数据管道比客户还多)
这类团队为了交付一款产品,搭建了极其庞杂的基础设施。每一个组件都引入了各自特有的 API、Schema 与数据类型,而整条数据流往往只存在于某一位工程师的脑海里。
我们经常见到的一种典型架构是:Postgres + PostHog + Dagster + Fivetran + dbt + BigQuery——仅仅是为了获取一些最基础的产品使用情况洞察。
尽管我们在数据库领域摸爬滚打了十年,要搭好这套体系也得脱一层皮——更不用说未来的 AI 软件工程智能体(SWE Agent)该如何驾驭它了。而且,你到底什么时候才能真正写产品业务代码,而不是伺候你的数据栈?
b. 亟需规范化数据管理的敏捷团队
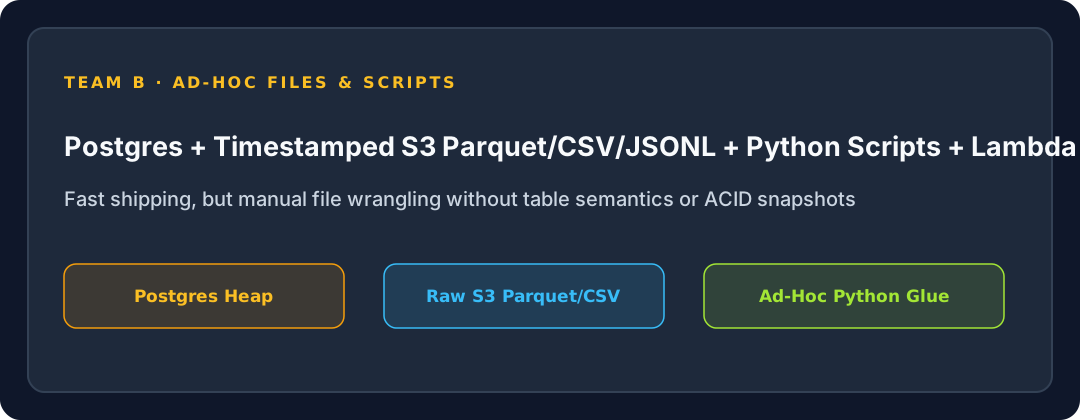
另一类团队在极其精简的基础设施上快速交付了大量产品功能——通常只有一张 Postgres 表、一堆零散文件(CSV、Parquet、JSONL)、Python 脚本和几个粘合一切的 Lambda 函数。
我很欣赏这类团队的执行力,但如果能把数据存进开放表格式(Iceberg 与 Delta Lake)而不是散乱的文件里,他们会轻松得多:再也不用在成百上千个带时间戳的 Parquet 文件里翻找缺失值,也不必在 DataFrame 里痛苦地手工拼接文件与数据库表。
遗憾的是,这些团队往往根本不知道开放表格式技术的存在——这也怪不得他们。数据领域的行话太多、上手门槛太高,搭建整套基础设施的机会成本更是令人望而却步。顺便问一句,你试过直接往一张 Iceberg 表里写数据吗?祝你好运!
2. 数据库执行引擎正在走向同质化与商品化
我们看到几乎所有数据库都在实现相同的优化技术,彼此模仿。数据库领域的蛋糕被切得如此细碎,以至于市场上只剩下诸如“实时!”、“极速分析!”之类空洞的营销词汇。
这正是我们坚定看好 Apache Iceberg 和 Delta Lake 等开放表格式的原因:在开放存储中只保留一份数据副本,并由不同的无状态执行引擎按需计算,能够让各方激励保持一致,创造真正的正和博弈。
3. AI 智能体(Agents)同样需要存算分离
存算分离在历史上为“人类开发者”创造了极佳的体验:Serverless、数据分支(Branching)、只读副本、缩容至零(Scale to 0)以及更低的成本。
对于 AI 智能体而言,存算分离同样具有不可抗拒的吸引力。随着思维链(Chain-of-Thought)与推理模型的发展,LLM 不再局限于对固定知识库发起简单的函数调用——智能体将会频繁地写入和更新数据表,并使用 Python 执行复杂的数据转换。
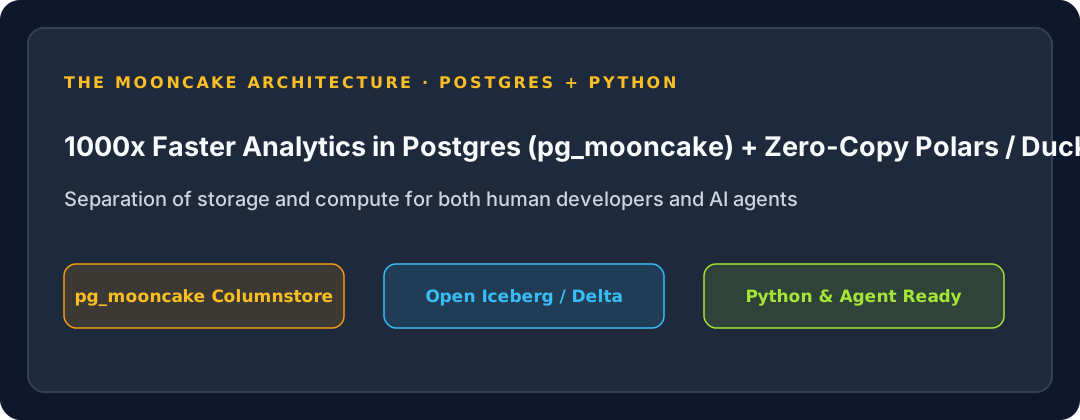
Mooncake 的核心拼图:你只需要 Postgres 和 Python
首先,借助 pg_mooncake 列存表,你可以直接在 PostgreSQL 内部获得快 1000 倍的分析性能,而使用体验就像操作普通 Postgres 表一样简单自然。
“我们非常兴奋看到 Mooncake 将易用的列存表带入 Postgres……Mooncake 正是我们在保持 Postgres 架构不变的前提下实现数据基础设施现代化所需要的关键拼图。”
— Max Muoto
其次,在 Postgres 之外,你可以直接使用 Polars、DuckDB 和 Pandas 查询这些底层开放格式表,无需任何繁琐的 DataFrame 转换或格式清洗。
创业第 61 天,前方还有许多系统等待我们超越 🙂
前路漫漫,但我们的核心原则不会改变。
🥮
1.15 - Iceberg Meetup 参会随想
上个月,我在 Snowflake 总部举办的 Iceberg Meetup 上做了一场演讲。公开演讲从来都不是我的强项,而台下坐着 Snowflake CEO Sridhar 和 Tabular CEO Ryan 更是让人倍感压力。
那天是我创立 Mooncake Labs 的第 18 天,我在演讲中探讨了面向 Apache Iceberg 的通用索引框架(演讲幻灯片见这里)。以下是我从这次聚会中收获的几点启发:
1. 伟大的产品是其社区的映射
过去十年里,我一直在构建一款商业闭源数据库。每当收到新的功能需求时,工程与产品负责人都会花上几个小时评估优先级。几乎每一次,讨论最终都会归结为一个问题:这能带来多少 ARR(年度经常性收入)? 我亲眼看着最优秀的工程师耗费数月时间,去编写那些与整体架构格格不入的定制钩子和扩展。我当时常常想:直接让客户提个 PR 不就好了吗 :) 这种以 ARR 为导向的优先级排序流程,最终拼凑出来的产品往往像下面这个怪异的汉堡一样:
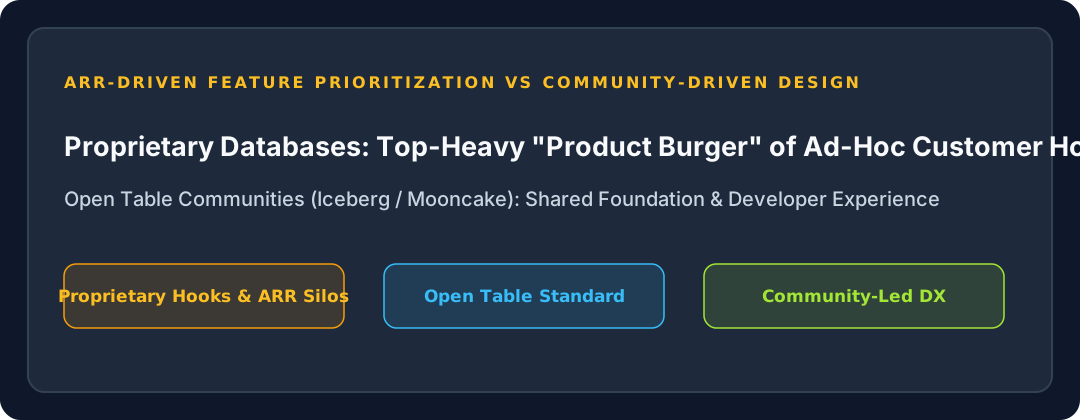
而 Iceberg 社区给人的感觉完全不同。大家有着清晰一致的终极目标,贡献者与用户并肩协作,开发者体验(DX)处于最核心的位置。这种氛围令人耳目一新——这才是打造受人喜爱的产品的正确方式。
我非常期待以开源方式构建 Mooncake 并凝聚社区。成功的产品总是映射出它背后的人群——无论是构建者还是使用者。
2. 开放表格式依然处于极其早期的阶段
虽然现场的许多讨论都聚焦在推进 Iceberg 的技术前沿——例如元数据缓存、v3 格式、优化的删除文件(Deletion Files)——但同样也有大量问题停留在最基础的层面。我经常被问到:“什么是 Catalog(目录),为什么我需要它?”
而在与一些 AI 开发者和产品工程师交流时,这些概念甚至更加陌生:
“Iceberg 到底是个啥 && 什么是数据湖(Lake)?”
这些开发者在 S3 上存了一堆文件,他们其实非常需要“表语义(Table Semantics)”——他们正饱受手动管理文件、用 Python 脚本处理数据、再把处理后的数据集提供给线上应用的折磨。他们本该是湖仓一体(Lakehouse)最直接的受益者,但许多人甚至从没听过这个词。
很显然,我平时生活在 Twitter 数据技术圈的狭小信息茧房里。最前沿的科技巨头确实正在围绕开放表格式进行技术收敛,但距离它成为每一位普通产品工程师手头的标准工具,还有很长的路要走。
首先,开放表格式的接口、语法和术语必须贴合现代应用开发者的习惯。搭建一套数据湖仓基础设施,绝不应该需要十几名专职数据工程师才能搞定。
希望 Mooncake 能在加速这一普及进程中贡献一份力量 🙂
3. 极致的性能突破即将到来
我在 Databricks SQL、DuckDB、Snowflake 和 StarRocks 的一些朋友正在全力针对开放表格式优化他们的查询引擎。我非常熟悉这种技术演进的节奏——它通常从 2 倍的性能提升开始,随后快速产生复利效应,最终带来数量级的飞跃。
有状态(Stateful)系统在 OLTP 或 HTAP 领域永远有一席之地;但我们很难不去畅想这样一个未来:ML/AI 数据处理、分析查询(无论是后台报表还是面向用户的实时分析)以及即席查询(Ad-hoc Queries),都将以完全无状态(Stateless)的方式直接运行在这些开放表格式之上。
我个人最感兴趣的是自适应查询执行(Adaptive Query Execution,参见 PVLDB, 17(12): 3947 - 3959, 2024)领域的进展。这一直是我长期关注的方向,但在过去的经历中我始终未能说服团队将其彻底落地。如今看到它在数据湖仓上的实现甚至超越了大多数传统数据仓库,实在令人振奋!
——在很多方面,开放表格式的时代与当下的 AI 时代颇为相似:前景无比广阔,先行者已经从中斩获巨大成功;但一切才刚刚拉开序幕 🥮
1.16 - 我们学到的几条铁律
这篇文章的标题其实应该叫《我们用惨痛代价学到的几条铁律》。
在开启这段全新旅程之际,我们花了一些时间思考当今数据领域的底层公理——这些规律无论我们还是任何人都无法回避。
1. 只要 Postgres 能做的事,最终都会由 Postgres 来做
这一幕我们已经见过太多次了——最早是 JSON,接着是地理空间数据(PostGIS),而现在则是向量检索(pgvector)。
过去,性能曾经是决胜的主战场。在之前的职业生涯里,我们打过无数场性能战役,而且赢下了绝大部分。但不知为何,我们赢了战役,却没能赢下整场战争。
在上一家公司(SingleStore),我们打造了业界最快的通用向量数据库,甚至还在顶会上发表了论文(SingleStore-V: PVLDB, 17: 3772 - 3785, 2024)。但即便如此,依然不够。
QPS 和吞吐量看起来平平无奇的 pgvector——最终赢下了市场。
为什么?因为它“足够好用”,而且它就在 Postgres 里面,触手可及。
永远不要对抗万有引力。Postgres 就是数据世界的万有引力。
2. 开放表格式时代才刚刚进入第 0 局,入场打球吧
开放表格式(Iceberg、Delta、Hudi)如今风头无两。Tabular 的天价收购更是火上浇油。仿佛一夜之间,全世界的数据都变成了开放格式,而且这一切似乎都是在过去 6 个月内发生的。
真相究竟如何?我们最近参加了在旧金山举办的 Iceberg Meetup,还在会上做了一场分享(详见后续文章)。与我们同台的有 Snowflake CEO Sridhar Ramaswamy、Tabular 创始人 Ryan Blue,以及世界上最顶尖的一批数据工程师。然而整场聚会只有大约 30 个人——而且主要来自两家大客户。按照旧金山的标准,这个规模小得惊人。那铺天盖地的热潮到底是怎么回事?
开放表格式还没有吞噬世界——甚至连边都还没摸到。但它们终将做到。此时此刻,开放表格式对绝大多数普通开发者而言还很遥远,但这一切很快就会改变。无论从工程视角还是生态视角来看,它都是真正正确的架构——一种能够团结整个开源与数据社区的架构。
而当整个社区团结一致、对某项技术建立起深厚信仰时,你可以笃定,真正波澜壮阔的变革即将发生。
这就是开放表格式正在酝酿的力量。围绕开放表格式的“复仇者联盟”正在集结,难道你要逆势而行吗?
数据版图的熵增与演进是永恒的常量
在我们并不算漫长的职业生涯中,就已经亲眼见证了:
- Hadoop 生态系统的崛起与崩塌
- MySQL 从王座上跌落
- “大数据(Big Data)”以及如今“小数据(Small Data)”等概念的诞生与更替
我们或许正身处新一轮技术浪潮之中。也许 Postgres 和开放表格式未必能吞噬一切,但它们确实把开发者放在了舞台中央,并为开发者提供了 A+ 级的体验。这本身就足以令人热血沸腾。
开发者永远是最终的赢家。🥮
2 - 版本发布说明
2.1 - pg_mooncake 0.3.0 发布:PGSTY 首版发布,全面适配 DuckDB 2.0、pgrx 0.19.3 与 PostgreSQL 14–18
pg_mooncake 0.3.0(随同 duckdb_mooncake v0.0.2 与 moonlink v0.0.1 同步发布)是由 PGSTY 维护的 Mooncake 实时分析套件的首个正式版本:
pgsty/pg_mooncake v0.3.0(MIT许可证)pgsty/duckdb_mooncake v0.0.2(MIT许可证)pgsty/moonlink v0.0.1(附带PG_MOONCAKE LINKING & DISTRIBUTION EXCEPTION的BSL-1.1许可证,客户端 crate 为MIT)
面向 PostgreSQL 14、15、16、17、18,覆盖 RHEL / Rocky / AlmaLinux 8、9、10 与 Debian 12/13、Ubuntu 22.04/24.04(x86_64 与 aarch64)的 RPM 与 DEB 二进制软件包现已通过 PGEXT 软件源与 Pigsty 正式提供。
pg_mooncake 0.3.0 核心亮点
1. 升级至 pgrx 0.19.3,全面支持 PostgreSQL 14–18
pg_mooncake 已完成向 pgrx = 0.19.3(cargo-pgrx 0.19.3)的迁移,在支持 PostgreSQL 14、15、16、17 的基础上正式引入对 PostgreSQL 18 的原生支持:
- 更新
pg_mooncake.control中的扩展元数据(default_version = '0.3.0'),并新增升级脚本sql/pg_mooncake--0.2.0--0.3.0.sql。 - 将所有 GUC 参数定义(
mooncake.timeline_id、mooncake.enable_local_bucket、mooncake.default_bucket、mooncake.enable_memory_metadata)全面迁移至 Rust 原生CStr字面量(c"...")。
2. 适配 DuckDB 2.0.0 与 pg_duckdb 1.2.0
pg_mooncake 0.3.0 内嵌 pg_duckdb v1.2.0 与 duckdb_mooncake v0.0.2,基于 DuckDB v2.0.0(d54cbbe3df17e8e5ce68312f483b4155836112aa)构建:
- 将
duckdb_mooncake完整迁移至 DuckDB 2.0 的TableCatalogEntry、StorageExtensionInfo与TableFilterSet迭代器接口。 - 修复了
MooncakeScanFunction中针对IS NULL与IS NOT NULL谓词下推的列索引重映射缺陷,消除了多列混合过滤条件下推至 Moonlink Parquet 扫描时的段错误(SIGSEGV)。 - 在后台工作进程初始化阶段新增
pg_duckdb运行时版本校验,强制要求pg_duckdb = 1.2.0(支持1.2.0或1.2.0-*预发布后缀;当检测到1.1.3或1.3.0等不匹配版本时立即快速失败并给出明确提示)。
3. 列存表 LSN 一致性快照读取(pg_current_wal_flush_lsn)
在旧版本中,duckdb_mooncake 以 lsn = 0 构造 Moonlink 表扫描描述符,导致查询不会等待刚刚提交的 PostgreSQL 事务被后台逻辑复制工作进程消费完毕。
在 v0.3.0 中,pg_mooncake 导出了 C 符号 mooncake_get_postgres_lsn()(在常规后端会话中调用 pg_current_wal_flush_lsn(),在恢复模式下返回 0),由 duckdb_mooncake 通过 dlsym(RTLD_DEFAULT, "mooncake_get_postgres_lsn") 动态解析。现在,对 columnstore 表的每一次分析查询都会自动等待 Moonlink 同步至当前 PostgreSQL WAL 刷盘 LSN 后再执行扫描。
4. 分区表层级自动支持(REPLICA IDENTITY FULL)
在对 PostgreSQL 分区表调用 mooncake.create_table(dst, src) 时,pg_mooncake 0.3.0 会自动遍历继承树(find_all_inheritors),在将主表加入逻辑复制发布之前,自动为父表及所有叶子分区表设置 REPLICA IDENTITY FULL。
5. 对已弃用的 mooncake.load_files 显式返回 0A000 错误
旧版 v0.1 遗留的辅助函数 mooncake.load_files(dst TEXT, files TEXT[]) 现在会显式抛出标准 PostgreSQL 错误码 ERRCODE_FEATURE_NOT_SUPPORTED(0A000)并给出清晰的迁移提示,而不再触发未捕获的 Rust todo!() 崩溃。
6. Cargo 依赖安全审计与加固(RustSec)
全部三个 Cargo 工作区(pg_mooncake、moonlink、duckdb_mooncake/moonlink_ffi)均对照 RustSec 漏洞数据库(2026-11-05)完成了系统性安全升级:
pg_mooncake/Cargo.lock:已知漏洞从 33 个降至 6 个(-82%),unsound 警告清零(1 -> 0)。moonlink/Cargo.lock:已知漏洞从 46 个降至 15 个(-67%),unsound 警告清零(1 -> 0)。duckdb_mooncake/moonlink_ffi/Cargo.lock:0 个漏洞、0 个 unsound、0 条警告。- 升级了
tonic 0.14.5、prost 0.14.3、bincode 2.1.0、opentelemetry 0.31.0、wasmtime 43.0.1、rustls 0.23.37、aws-lc-rs 1.16.3、bytes 1.11.1、tar 0.4.45与lz4_flex 0.11.6。完整审计详情请参阅 SBOM 与安全审计。
验证总结
pg_mooncake 0.3.0 已在 Ubuntu 24.04.5 LTS ARM64(PostgreSQL 18.6) 与 Rocky Linux 10.2 ARM64(PostgreSQL 17.11) 双平台上完成端到端实机验证:
- 58/58 项 Moonlink
table_handler单元测试全部通过。 - 3/3 组
pg_RegressionSQL 回归测试集(small、partition、unsupported)全部通过(0失败)。 - 运行时版本门禁实测验证:准确拦截
pg_duckdb 1.1.3与1.3.0,放行1.2.0。 - 11/11 项实时逻辑复制、
UPDATE/DELETE、分区表同步、Iceberg 元数据访问及数据库快速重启持久化检查点全部通过。
2.2 - pg_mooncake v0.2 架构前瞻:开箱即用的实时列存与逻辑复制
在 v0.1 中,我们证明了 PostgreSQL 完全能够提供顶级的分析性能。通过将 DuckDB 向量化执行引擎与列存表相结合,pg_mooncake 成为了 Postgres 生态中唯一同时集成这两大能力的扩展。
实测成绩说明了一切:pg_mooncake 闯入了 ClickBench 全球前十,并打造出了最快的基于 Parquet 的执行引擎。
现在,在 v0.2 中,我们正在攻克下一个核心挑战——我们称之为**“开箱即用的分析(Out-of-the-Box Analytics)”**。
为什么要在 Postgres 内部直接做分析?
绝大多数应用在真正拥有第一套数据仓库或专用分析系统之前,早就已经产生了迫切的分析查询需求。
我们见过无数次相同的故事:团队不得不推迟产品路线图、搭建通往外部系统的数据同步管道、招聘专职数据工程师维护 ETL——同时还要在应用层把 Postgres 里的实时业务数据与外部系统里的分析数据手工拼凑在一起。
pg_mooncake 彻底消除了这种复杂性。借助列存表,开发者可以在同一个 Postgres 数据库中同时处理事务型(OLTP)与分析型(OLAP)负载——没有外部系统,没有脆弱的 ETL 管道,只有纯粹的 Postgres。
在 v0.2 中,我们重点围绕以下几个核心方向展开架构演进:
1. 完善的 Postgres 表访问方法(TAM)与兼容性 (#80)
在 v0.1 中,所有针对列存表的读写都直接穿透到 DuckDB 执行,虽然带来了极高的扫描性能,但也导致部分 Postgres 原生特性(如数据修改 CTE、触发器等)受限。在 v0.2 中,我们将源表的写入完全交回给 Postgres 原生堆表,由 DuckDB 专注于高速列存扫描与计算下推。
2. 基于逻辑复制(Logical Replication)的列存镜像同步 (#90)
许多用户都是在现有 Postgres 业务表遇到慢查询瓶颈后开始引入 pg_mooncake 的。通过引入逻辑复制架构(参见 mooncake.create_table),用户无需修改任何业务端写入代码,只需一条命令即可将现有 Postgres 堆表(或远程 RDS / Cloud SQL / Neon / Supabase 表)的数据实时同步至列存镜像表中。
3. 面向高频小写入的内存/行存写缓冲 (#89)
逻辑复制带来了一个核心工程挑战:如何在高频小事务写入下,避免每个事务都生成一个零碎的 Parquet 小文件和元数据日志?
在 v0.2(基于 Moonlink 引擎)中,高频小批量写入会首先进入内存中的 Arrow 写缓冲区(Write Buffer),达到阈值后再由后台异步刷盘生成紧凑的 Parquet 文件。当查询列存表时,duckdb_mooncake 会自动合并读取内存缓冲区与底层 Parquet 文件(Union Read)。这一机制将 Parquet 文件写入与 OLTP 事务彻底解耦,大幅消除了写放大。
这一突破使得列存表无需业务层手工攒批(Batching)即可直接对接高并发 OLTP 负载,非常适合实时 HTAP、日志分析与时序数据场景。
这为我们带来了什么?
pg_mooncake 是获取 Postgres 原生极速分析最简单的方式。随着 v0.2(以及 PGSTY 维护的 v0.3.0 版本)的落地,三大核心场景得到了全面增强:
- 面向用户的实时分析(User-Facing Analytics) —— 完整的 ORM 支持、与普通 Postgres 表直接 JOIN、只需运维一套数据库;
- 日志、对话历史与时序数据 —— 针对高频追加写入深度优化,兼具 Parquet 高压缩率与低存储成本;
- 开箱即用的开放数据湖仓 —— 将 Postgres 变身为实时生成 Apache Iceberg 快照的引擎,并配合具备文件跳过与行组裁剪能力的极速 Parquet 执行引擎。
2.3 - PostgreSQL 中最简单的极速分析方式:pg_mooncake v0.1 正式发布
我们在创业第 60 天向世界首次宣布了 pg_mooncake。
今天(第 131 天),pg_mooncake 正式结束 Beta 阶段,发布 v0.1.0。
pg_mooncake 的核心竞争力在于极致易用性与强悍性能。在 v0.1 中,我们在这两个方向上全力加码。
在 Postgres 中运行极速分析最简单的方式
凭借 Postgres 原生列存表,pg_mooncake 将开发者最熟悉的表语义带入分析场景。列存表不仅支持事务性的 INSERT、SELECT、UPDATE、DELETE 和 COPY,还能直接与普通 Postgres 堆表执行关联查询(JOIN)。
在 v0.1 中,我们让向列存表导入数据变得更加简单:
- 直接读取 Parquet、CSV 与 JSON 文件:
- 直接从 Hugging Face 数据集导入:
- 直接查询外部现有的 Iceberg 与 Delta Lake 表:
时序与分析负载性能大幅跃升
pg_mooncake 是唯一同时为 Postgres 提供列式存储与向量化执行的扩展。
在 v0.1 中,我们引入了文件级统计信息与数据块跳过(File Skipping / Segment Elimination),让用户无需传统分片即可轻松承载大规模时序与分析负载。
我们的 ClickBench 官方基准测试成绩将于下周揭晓(剧透:闯入全球前十 🙂)。事实证明,PostgreSQL 完全可以成为一流水准的实时分析数据库。
展望 v0.2
接下来我们将重点聚焦在开发者体验(DevEx)与实时同步能力上,规划中的改进包括:
- 增强对高频小批量写入、更新与删除的支持
- 将行存堆表(Rowstore)实时同步至列存表(Columnstore)
- 索引支持(二级索引与排序键)
- 时序分析函数
致谢社区
独行快,众行远。衷心感谢我们的社区用户、代码贡献者以及 Neon、Supabase 等 Postgres 生态伙伴的鼎力支持。
我们最珍视的指标,就是 pg_mooncake 开源贡献者人数的持续增长。pg_mooncake 的势头已经势不可挡,Postgres 原生分析时代已然到来 🥮