简介与核心架构v0.3.0
全面了解 Mooncake 架构:解析 pg_mooncake、moonlink、duckdb_mooncake 与 pg_duckdb 1.2.0 的协同机制,以及从 v0.1 到 v0.2 / v0.3 的演进。
这是本节的多页打印视图。 .
全面了解 Mooncake 架构:解析 pg_mooncake、moonlink、duckdb_mooncake 与 pg_duckdb 1.2.0 的协同机制,以及从 v0.1 到 v0.2 / v0.3 的演进。
通过 Pigsty 软件包或从源码安装 pg_mooncake 与 pg_duckdb,跟随 Hello World 教程创建第一张列存镜像表,并了解当前已知限制。
完整查阅 mooncake.create_table、create_snapshot、optimize_table、list_tables 存储过程、支持的查询形态、Iceberg S3/R2 配置与外部数据湖扫描。
实时操作分析(HTAP)、时间分区大表冷热归档、零 ETL Postgres 湖仓一体以及 OpenTelemetry 日志分析的架构与 SQL 实践。
完整保留 pg_mooncake v0.1(USING columnstore + Delta Lake 存储)历史技术文档,供旧版存量部署参考并兼容 Wayback 历史链接。
PGSTY 社区维护说明、MIT 与 BSL-1.1 链接豁免许可证条款、Wayback Machine 历史文档恢复来源以及 Cargo 依赖安全审计报告。
深入解析写入路径(Logical WAL -> Moonlink)、读取路径(pg_duckdb -> duckdb_mooncake)以及双层列存格式(内存 Arrow + Parquet + Apache Iceberg v2)。
实时逻辑复制 CDC、Arrow 内存写缓冲、Roaring Bitmap 删除向量、LSN 快照一致性屏障,以及独立 moonlink_service REST/RPC 服务部署。
了解 duckdb_mooncake v0.0.2 如何连接 DuckDB 2.0 与 Moonlink 元数据,并利用多文件 Parquet 统计信息接口实现高效分段跳过。
使用 CALL mooncake.create_table(...) 将本地或远程(src_uri)PostgreSQL 普通表及分区表复制为 USING mooncake 实时列存镜像表。
配置 mooncake.default_bucket 指向 AWS S3 或 Cloudflare R2,调用 mooncake.create_snapshot 物化快照,并通过外部引擎直接读取。
在 PostgreSQL 内直接查询外部 Parquet、CSV、JSON、Apache Iceberg、Delta Lake 及 HuggingFace 数据集,并与本地行存表直接关联。
pg_mooncake 是一款 PostgreSQL 扩展,能够在数据库内部直接提供实时列存镜像表(USING mooncake)、基于 DuckDB 2.0 的向量化分析执行引擎(通过 pg_duckdb 与 duckdb_mooncake),以及开放的 Apache Iceberg v2 湖仓存储(由 moonlink 驱动)。
搭载 pg_mooncake 的 PostgreSQL 在 ClickBench 分析基准测试中名列前茅,同时完全保留原有的 PostgreSQL 事务写入路径。该扩展套件原由 Mooncake Labs 开发,现由 PGSTY 社区维护(包含 pg_mooncake v0.3.0、duckdb_mooncake v0.0.2 与 moonlink v0.0.1),全面支持 PostgreSQL 14–18。
v0.3.0)pgsty/pg_mooncake(v0.3.0,MIT 许可证):PostgreSQL 核心扩展,提供 USING mooncake 表访问方法、mooncake.* SQL 存储过程以及内嵌的 Moonlink 后台工作进程(基于 pgrx 0.19.3)。pgsty/moonlink(v0.0.1,BSL-1.1 附带 pg_mooncake 链接与分发豁免):Rust 实时列存摄取引擎,通过 PostgreSQL 逻辑复制接收 WAL 变更,维护内存 Arrow 写缓冲区、Roaring Bitmap 删除向量以及 Apache Iceberg v2 / Parquet 文件。pgsty/duckdb_mooncake(v0.0.2,MIT 许可证):随 pg_mooncake 一同打包的 DuckDB 2.0 存储扩展,支持扫描 Moonlink 表并利用多文件 Parquet 统计信息执行高效分段跳过。PostgreSQL 是极其优秀的事务型(OLTP)数据库,但其面向行的堆表存储与逐行执行器并非为大规模分析扫描(OLAP)而设计。长期以来,PostgreSQL 用户往往面临两难选择:
INSERT、UPDATE、DELETE 时产生海量微小的 Parquet 文件(小文件风暴),导致读写性能迅速劣化。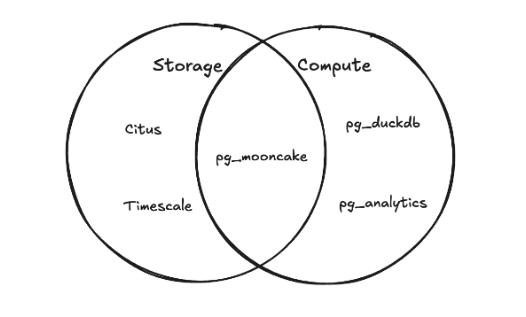
pg_mooncake 的解决之道
从 v0.2 架构重设计并在 PGSTY 维护的 v0.3.0 版本中进一步完善,pg_mooncake 采用了**实时列存镜像(Columnstore Mirror)**架构:
trades 行存表执行 INSERT、UPDATE、DELETE,享受完整的 ACID 事务与行存索引性能。pg_mooncake 后台工作进程将 WAL 变更实时推送至 moonlink;最新写入在内存中缓冲为 Apache Arrow 列存批次,UPDATE 与 DELETE 通过 Roaring Bitmap 删除向量就地标记,并在后台异步刷盘与合并为 Parquet 文件。trades_analytics 的分析查询由 pg_duckdb 1.2.0 与 duckdb_mooncake v0.0.2 接管,在等待目标 WAL LSN 同步屏障后,零拷贝融合扫描内存 Arrow 缓冲与磁盘 Parquet 文件。CALL mooncake.create_snapshot('trades_analytics') 即可在本地磁盘、AWS S3 或 Cloudflare R2 上生成标准 Apache Iceberg v2 元数据快照,无需任何 ETL 即可供 Spark、Snowflake、DuckDB 或 PyIceberg 直接读取。深入了解 pg_mooncake、pg_duckdb、duckdb_mooncake 与 moonlink 如何协同完成写入、查询与 Iceberg 快照生成。
深入剖析 Moonlink(v0.0.1)的内存 Arrow 写缓冲、删除向量机制,以及独立 HTTP/RPC 服务部署方式。
了解 duckdb_mooncake v0.0.2 如何适配 DuckDB 2.0 与 pg_duckdb 1.2.0,实现多文件 Parquet 统计信息剪枝。
对比早期 v0.1 Delta Lake(USING columnstore)架构、v0.2 Moonlink 镜像架构以及 PGSTY v0.3.0 的工程改进。
pg_mooncake(v0.3.0)在单个 PostgreSQL 实例内部深度融合了三个核心组件:
pg_duckdb(v1.2.0):在 PostgreSQL 进程内嵌入 DuckDB v2.0.0 向量化分析执行引擎,并将涉及非堆表访问方法的分析查询路由至 DuckDB 执行。moonlink(v0.0.1):内嵌于 pg_mooncake 后台工作进程中的 Rust 实时列存引擎,负责消费 PostgreSQL 逻辑复制流、维护内存 Apache Arrow 写缓冲区与 Roaring Bitmap 删除向量、刷写 Parquet 数据文件,并生成 Apache Iceberg v2 表元数据。duckdb_mooncake(v0.0.2):随 pg_mooncake 打包至本地扩展目录(mooncake.extension_repository)并自动加载的 DuckDB 2.0 C++/Rust 存储扩展。它通过本地 Unix 域套接字 RPC(pg_mooncake/moonlink.sock)与 Moonlink 通信,融合扫描磁盘 Parquet 文件与内存 Arrow 批次。三者共同向 PostgreSQL 暴露了原生的 USING mooncake 表访问方法(Table Access Method),并通过 CALL mooncake.create_table(dst, src) 进行统一管理。
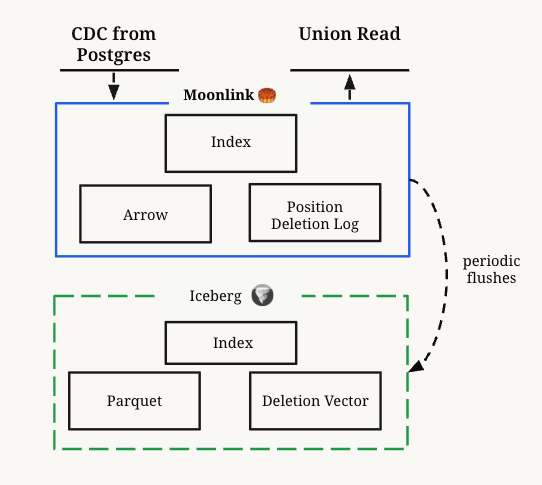
pg_mooncake 0.3.0 组件版本矩阵
| 组件名称 | 版本 / 标签 | 锁定提交 (versions.json) |
核心职责 |
|---|---|---|---|
pg_mooncake |
v0.3.0 |
1a9cbfd65be9a6486d020120acb49ef0c6800d68 |
PostgreSQL 扩展(基于 pgrx 0.19.3)、SQL 存储过程、USING mooncake TAM 与后台工作进程管理 |
moonlink |
v0.0.1 |
b298ef7444890e3c8af5544e350232518bcfd8e5 |
内嵌式 Rust CDC 实时摄取引擎、Arrow 写缓冲、删除向量与 Iceberg v2 快照写入器 |
duckdb_mooncake |
v0.0.2 |
49765a369ad88986916ce53c969ed2ce4ba66fac |
DuckDB 2.0 存储扩展(mooncake.duckdb_extension),负责扫描 Moonlink 表与 Parquet 统计剪枝 |
pg_duckdb |
v1.2.0 |
8756099e267c47f0b86c24de4cf995327f1f4279 |
PostgreSQL 内嵌 DuckDB 执行桥接扩展(由扩展安装 SQL 版本守卫严格校验) |
duckdb |
v2.0.0 |
d54cbbe3df17e8e5ce68312f483b4155836112aa |
底层 C++ 向量化分析查询执行引擎 |
在 pg_mooncake 中,用户不直接向 USING mooncake 列存表执行写入,而是继续向原有的 PostgreSQL 行存表(普通堆表或分区表)写入数据:
CALL mooncake.create_table('dst', 'src') 时,pg_mooncake 会自动完成以下步骤:
src 的列定义,创建采用 USING mooncake 访问方法的目标镜像表 dst。REPLICA IDENTITY FULL(在 v0.3.0 中,若源表为分区表,还会自动遍历并为所有现有叶子分区设置 REPLICA IDENTITY FULL)。pgoutput),将源表存量数据拷贝至 Moonlink,并记录初始一致性 WAL LSN。mooncake_bgworker)持续从逻辑复制槽读取增量 WAL 变更(INSERT、UPDATE、DELETE)并写入 moonlink。32 MB),无需在每次事务提交时生成微小 Parquet 文件即可让新数据立即可查。CALL mooncake.create_snapshot('dst') / CALL mooncake.optimize_table('dst', 'full') 时,Moonlink 将内存 Arrow 批次刷写为压缩的 Parquet 文件,并更新 Apache Iceberg v2 元数据。当执行涉及 USING mooncake 列存镜像表的 SELECT 查询时:
pg_duckdb 路由查询:PostgreSQL 查询规划器识别出已通过 RegisterDuckdbTableAm("mooncake") 注册的 mooncake 表访问方法,将分析算子下推至进程内的 DuckDB 2.0 引擎。pg_mooncake 自动设置 SET extension_directory = '<mooncake.extension_repository>',加载 mooncake DuckDB 扩展(duckdb_mooncake v0.0.2),并执行 ATTACH '' AS mooncake (TYPE mooncake, METADATA '<pgdata>/pg_mooncake')。duckdb_mooncake 获取当前 PostgreSQL 的 WAL 写入位点 LSN,并通过 RPC(scan_table_begin)通知 Moonlink 等待逻辑复制流推进至该 LSN,从而保证事务级强一致性读取。duckdb_mooncake 通过 DuckDB 2.0 导出的多文件读取器接口读取 Parquet 列的最小/最大值统计信息,自动跳过不满足过滤条件的文件与行组(Segment Elimination),应用删除向量过滤后将结果流式返回给 PostgreSQL。默认情况下(mooncake.default_bucket = ''),Moonlink 将表元数据、删除向量与 Parquet 数据文件存储在 PostgreSQL 数据目录下的 $PGDATA/pg_mooncake/ 中。
当将 mooncake.default_bucket 配置为 s3:// 或 r2:// 路径(并在 duckdb.secrets 中配置对象存储凭据)时,Moonlink 会将 Parquet 数据文件与 Apache Iceberg v2 元数据(metadata/*.metadata.json 及 Avro 清单文件)直接写入对象存储。你可以随时通过以下 SQL 查看每张镜像表的 LSN 同步进度与 Iceberg 仓库路径:
Moonlink(pgsty/moonlink,当前正式版本 v0.0.1)是一个使用 Rust 编写的高性能实时列存摄取库与独立服务,旨在无需引入 Apache Spark 或 Kafka 的前提下,面向在线业务系统与事件流实时构建并维护 Apache Iceberg v2 与 Delta Lake 表。
在 pg_mooncake 内部,Moonlink 作为内嵌的 PostgreSQL 后台工作进程(mooncake_bgworker)运行,并通过本地 Unix 域套接字($PGDATA/pg_mooncake/moonlink.sock)提供低延迟 RPC 通信;同时,它也可以独立编译并部署为对外提供 HTTP REST 与 gRPC 接口的摄取服务(moonlink_service)。
BSL-1.1 附带 pg_mooncake 链接与分发豁免)核心 moonlink 服务端引擎采用 BSL-1.1 许可证(将于 2029-05-05 自动转换为 Apache-2.0),并附带明确的 PG_MOONCAKE LINKING & DISTRIBUTION EXCEPTION(链接与分发豁免条款),允许在作为 pg_mooncake 的一部分嵌入或分发时不受限制地链接、修改与再分发。其协议与客户端库(moonlink_rpc、moonlink_proto、moonlink_error、moonlink_table_metadata)均采用 MIT 许可证。完整条款请参阅许可证说明。
传统数据湖写入器在**数据新鲜度(Freshness)与查询性能(Query Performance)**之间面临天然矛盾:如果每次单行写入都立即刷盘,会产生数以万计的微小 Parquet 文件;如果攒批 5–15 分钟再写入,又无法满足实时分析的延迟要求。
Moonlink 通过多级存储架构彻底消除了这一矛盾:
INSERT 与 UPDATE 新行首先追加至内存中的 Arrow RecordBatch 写缓冲区(write_buffer_size,默认 32 MB)。读取端(duckdb_mooncake)无需等待刷盘即可通过零拷贝 Arrow 接口直接扫描最新数据。UPDATE 与 DELETE,Moonlink 无需重写已有 Parquet 文件,而是通过 B-Tree 主键索引(moonlink_btree)定位旧行偏移量,并将其记录在压缩的 Roaring Bitmap 删除向量中。lsn 标记。查询在调用 scan_table_begin 时传入目标 LSN,仅当逻辑复制尚未追平该 LSN 时才短暂等待,确保强一致性读取。metadata.json 与 Avro 清单文件。moonlink v0.0.1 的核心工程修复
在 PGSTY 发布的 moonlink v0.0.1(b298ef7444890e3c8af5544e350232518bcfd8e5)版本中,包含了以下关键工程修复:
create_snapshot(lsn) 挂起的问题:此前,当数据库内其他无关表发生写入导致全局 WAL LSN 推进,而目标列存镜像表没有新事务提交时,调用 CALL mooncake.create_snapshot('table') 会无限期等待目标表达到最新数据库 LSN。在 v0.0.1 中,复制流进度通知会自动推进表级安全 LSN 水位线并立即刷写已提交的旧数据,即使该表后续没有新事务提交也能正常完成快照。aarch64)与 Ubuntu 24.04(aarch64)环境下全面验证了追加、更新、删除、回滚、文件合并与快照屏障场景。bytes、crossbeam-epoch、h2、lz4_flex、quinn-proto、rustls、rustls-webpki、webpki-roots、time、zstd、anyhow、event-listener、lru(0.18.5)、memmap2、rand、tokio(1.51.6)、aws-lc-rs 与 serial_test 等 20 余项安全公告。moonlink_service)
除了内嵌在 pg_mooncake 中运行外,你也可以将 moonlink_service 作为独立摄取服务器运行,通过 HTTP REST 或 gRPC 流式写入 Iceberg 表。
moonlink_service
独立服务默认监听 3030 端口,提供表创建、实时行写入与 Iceberg 快照生成的 JSON 接口:
快照生成后,任何兼容 Apache Iceberg 的计算引擎(DuckDB、Spark、Trino、Snowflake、PyIceberg)均可直接读取该表:
duckdb_mooncake(pgsty/duckdb_mooncake,当前正式版本 v0.0.2,MIT 许可证)是面向 DuckDB v2.0.0 的 C++ 与 Rust FFI 存储扩展。它使 DuckDB(无论是独立运行还是通过 pg_duckdb 1.2.0 内嵌在 PostgreSQL 中)能够直接挂载 moonlink 元数据目录,并对 Moonlink 表执行高性能向量化扫描。
pg_mooncake 0.3.0 中的核心角色
当 pg_mooncake 在 PostgreSQL 内执行针对 USING mooncake 列存表的查询时,pg_duckdb 会将表扫描算子委托给 DuckDB 执行。pg_mooncake 在初始化 DuckDB 会话时会自动执行以下命令:
mooncake.extension_repository)
不同于早期版本在运行时从远程社区存储桶下载扩展二进制文件,pg_mooncake 0.3.0 在编译和打包阶段即直接构建 mooncake.duckdb_extension(v0.0.2),并随 PostgreSQL 扩展一同安装至本地 DuckDB 扩展目录:
PostgreSQL 配置参数 mooncake.extension_repository 默认指向该目录(也可在 postgresql.conf 中显式指定自定义路径),配合 duckdb.allow_unsigned_extensions = true 实现完全离线、确定性、字节级一致的本地扩展加载。
v0.0.2 对 DuckDB 2.0 的关键适配
在 PGSTY 发布的 duckdb_mooncake v0.0.2(49765a369ad88986916ce53c969ed2ce4ba66fac)版本中,完成了面向 DuckDB v2.0.0(d54cbbe3df17e8e5ce68312f483b4155836112aa)与 pg_duckdb 1.2.0 的深度适配:
nanoarrow 0.7)、表函数绑定、多文件列表(Multi-File Lists)以及表过滤条件(Table Filter)下推接口。ParquetReader 的内部符号,而这些符号在 DuckDB 2.0 的 libduckdb.so 中已不再导出。duckdb_mooncake v0.0.2 改用 DuckDB 2.0 公开导出的多文件读取器接口(MultiFileReader)读取 Parquet 列级最小/最大值统计信息,并通过 ldd -r 验证与 pg_duckdb 的 libduckdb.so 之间零未解析动态符号。v0.0.2 改为在对象缓存互斥锁外部完成统计信息条目的构造,再原子写入缓存。Corrosion v0.5、nanoarrow 0.7 与 CRoaring v5.5.4(当系统缺少 libroaring 时执行 SHA-256 校验构建),并以 --locked 模式锁定 moonlink_ffi Rust 客户端依赖(RustSec 漏洞匹配数为 0)。你也可以在独立的 DuckDB v2.0.0 命令行(duckdb -unsigned)中直接加载 duckdb_mooncake,用于检查或查询 Moonlink 数据目录:
pg_mooncake 的技术架构经历了三个关键演进阶段:
v0.1(早期 Delta Lake 架构):引入直接通过 CREATE TABLE ... USING columnstore 创建的列存表,底层基于 Delta Lake 与早期 pg_duckdb 实现读写。v0.2(Moonlink 与 Apache Iceberg 架构重设计):废弃对列存表的直接写入,改用由 moonlink 逻辑复制驱动的**实时列存镜像(Columnstore Mirror)**架构(CALL mooncake.create_table(dst, src) + USING mooncake),引入内存 Arrow 写缓冲、Roaring 删除向量与 Apache Iceberg v2 元数据。v0.3.0(PGSTY 社区维护正式版):将 pg_mooncake 升级至 pgrx 0.19.3(全面支持 PostgreSQL 14–18),将 duckdb_mooncake v0.0.2 移植适配至 pg_duckdb 1.2.0 与 DuckDB v2.0.0,修复了 Moonlink(v0.0.1)在无关表推进 WAL 时的快照挂起问题与分区表复制标识设置,并修复了 20 余项 RustSec 依赖安全漏洞。v0.1 历史版本文档?早期 v0.1 版本(USING columnstore、mooncake.create_secret、mooncake.columnstore_tables、mooncake.read_parquet)的完整文档已归档保留在 v0.1 历史文档 (Delta Lake) 中。
| 特性维度 | v0.1(早期版本) |
v0.2(Moonlink 重构版) |
v0.3.0(当前 PGSTY 正式版) |
|---|---|---|---|
| 列存表创建方式 | CREATE TABLE t (...) USING columnstore; |
CALL mooncake.create_table(dst, src); |
CALL mooncake.create_table(dst, src, src_uri, table_config); |
| 表访问方法 (TAM) | USING columnstore |
USING mooncake(只读镜像表) |
USING mooncake(只读镜像表) |
| 写入路径设计 | 直接向列存表执行 DML(每笔事务生成 1 个 Parquet 文件) | 写入标准 Postgres 行存表,通过 moonlink 逻辑复制实时同步 |
写入普通堆表或分区表,通过 moonlink v0.0.1 逻辑复制实时同步 |
| 高频小写入与更新处理 | 高频小事务下产生大量小文件,更新需重写文件 | 亚秒级内存 Arrow 写缓冲 + Roaring Bitmap 删除向量 | 亚秒级 Arrow 写缓冲 + 删除向量 + 非阻塞 LSN 快照屏障 |
| 开放湖仓格式 | Delta Lake(mooncake.columnstore_tables) |
Apache Iceberg v2(mooncake.list_tables()) |
Apache Iceberg v2(mooncake.list_tables()) |
| DuckDB 执行引擎 | DuckDB 1.1 / pg_duckdb 0.2 |
DuckDB 1.3 / pg_duckdb |
DuckDB v2.0.0 / pg_duckdb 1.2.0(duckdb_mooncake v0.0.2) |
| PostgreSQL 版本支持 | PostgreSQL 14–17(pgrx 0.12) |
PostgreSQL 14–17(pgrx 0.16.1) |
PostgreSQL 14–18(pgrx 0.19.3) |
| 分区源表支持 | 不支持 | 支持(需手动为子分区设置复制标识) | 创建镜像时自动为所有现有叶子分区设置 REPLICA IDENTITY FULL |
v0.2 / v0.3 放弃了 v0.1 的直接写入模型?
v0.1 直接写入模型的局限性
在 v0.1 中,直接向 USING columnstore 表写入数据虽然在大批量导入(单事务 100,000–1,000,000 行)时表现良好,但在真实的在线 PostgreSQL 业务负载中存在明显瓶颈:
USING columnstore 表上创建主键、唯一约束、外键或 B-Tree 索引。INSERT 或 UPDATE 事务都会生成一个新的 Parquet 文件,在高频 OLTP 流量下会导致文件碎片激增、查询性能快速下降。v0.2 与 v0.3.0 如何解决这些问题
通过将 OLTP 写入路径(标准 PostgreSQL 行存表)与分析存储计算路径(moonlink + pg_duckdb 1.2.0 + duckdb_mooncake v0.0.2)彻底解耦:
moonlink 利用内存 Arrow 写缓冲与 Roaring 删除向量高效吸收高频 INSERT、UPDATE、DELETE 变更流,并在后台异步刷写与合并优化后的 Parquet 文件。ALTER TABLE ... ADD COLUMN 与 DROP COLUMN 会自动同步至列存镜像表。src_uri):你甚至可以在专门的分析型 PostgreSQL 实例上部署 pg_mooncake,通过 src_uri => 'postgresql://...' 实时镜像远程生产数据库(包括 AWS RDS、Aurora、Supabase 或 Neon)中的业务表。本指南介绍如何在 PostgreSQL 14、15、16、17 与 18 上安装 pg_mooncake(v0.3.0)(内嵌 moonlink(v0.0.1) 与 duckdb_mooncake(v0.0.2))及其依赖的 pg_duckdb(v1.2.0)。
在主流 Linux 发行版(el8、el9、el10、d12、d13、u22、u24、u26 × x86_64 / aarch64)上,最快、最可靠的安装方式是使用由 PGSTY 维护的 pig 包管理器。完整的各平台直链下载表请参阅下载与可用性矩阵。
postgresql.conf 并启用扩展
pg_mooncake 依赖 PostgreSQL 逻辑复制将行存表的增量变更实时同步至 Moonlink,并通过 pg_duckdb 加载本地打包的 mooncake.duckdb_extension。请在 postgresql.conf(或通过 ALTER SYSTEM)中配置以下参数:
重启 PostgreSQL 服务(例如 sudo systemctl restart postgresql-18 或 pig pg restart),随后使用 psql 连接目标数据库并创建扩展:
pg_duckdb 1.2.0 版本守卫说明在执行 CREATE EXTENSION pg_mooncake 时,扩展初始化 SQL 脚本会显式校验 pg_extension 中的 pg_duckdb 版本必须为 1.2.0。如果当前环境安装了不兼容的 pg_duckdb 版本(例如 1.1.x 或 1.3.x),安装将立即报错中止。请始终同步升级 pg_duckdb 与 pg_mooncake。
v0.3.0)
如果你需要从源码构建 pg_mooncake 0.3.0、pg_duckdb 1.2.0、duckdb_mooncake v0.0.2 与 moonlink v0.0.1:
postgresql-server-dev-14 至 18(或 postgresql17-devel / postgresql18-devel)cmake、ninja-build、g++ 或 clang、libssl-dev、libcurl4-openssl-dev、liblz4-dev、libzstd-dev、protobuf-compiler(protoc)1.99.0+(stable)以及严格匹配版本的 cargo-pgrx 0.19.3:
Obsolete(过时,待更新维护):PGSTY 尚未发布 pg_mooncake 0.3.0 的 Docker 与 Kubernetes 镜像。以下上游历史命令使用的是旧版 mooncakelabs/pg_mooncake 镜像(内置 PostgreSQL 17 与早期版本 pg_mooncake),仅供历史参考。
亲手创建你的第一张 USING mooncake 列存镜像表,体验事务写入、更新、回滚与跨表关联查询。
了解关于主键 / 复制标识、分区表行为、TRUNCATE 以及受支持 DDL 变更的工程约束。
本教程将带你体验 pg_mooncake 的核心操作流程:创建标准的 PostgreSQL 行存表,创建实时同步的列存镜像表(USING mooncake),执行事务级 INSERT、UPDATE、DELETE 与 ROLLBACK,以及在列存镜像表与常规行存表之间执行混合 JOIN 查询。
连接目标 PostgreSQL 数据库,确保已启用 pg_mooncake(及依赖的 pg_duckdb):
首先创建一张标准的 PostgreSQL 行存表(user_activity)用于承载业务写入,随后调用 mooncake.create_table 创建它的实时列存镜像表(user_activity_columnstore):
在后台,mooncake.create_table 会自动创建 user_activity_columnstore USING mooncake 表,为 user_activity 建立逻辑复制槽,并将表元数据注册到 moonlink 引擎中。
所有写操作(INSERT、UPDATE、DELETE)均针对原始行存表(user_activity)执行,而分析型 SELECT 查询则针对列存镜像表(user_activity_columnstore)执行:
查询输出:
Moonlink 仅从逻辑复制流中摄取已提交的 PostgreSQL 事务;未提交或已回滚(ROLLBACK)的事务绝不会出现在列存镜像表中:
你可以在两张列存镜像表之间执行关联查询,也可以在单条 SQL 中将 USING mooncake 列存镜像表与常规 PostgreSQL 行存表直接 JOIN:
通过 mooncake.list_tables() 查看当前的提交 LSN、刷盘 LSN 及 Iceberg 仓库目录,或调用 mooncake.create_snapshot 将内存 Arrow 写缓冲区强制刷盘并生成新的 Apache Iceberg v2 快照:
在生产环境部署使用 pg_mooncake(v0.3.0)之前,请仔细阅读以下架构约束与当前已知限制。
通过 CALL mooncake.create_table(dst, src) 创建的表采用 USING mooncake 表访问方法,本质上是只读列存镜像表:
USING mooncake 列存表执行 INSERT、UPDATE、DELETE 或 COPY(PostgreSQL 将直接拒绝修改)。src)执行,变更会通过 moonlink 逻辑复制自动同步至列存镜像。REPLICA IDENTITY FULL 要求
为了通过 PostgreSQL 逻辑复制准确同步 UPDATE 与 DELETE 操作,源表必须在 WAL 日志中提供完整的旧行标识:
CALL mooncake.create_table(dst, src) 会在启动复制前自动对源表执行 ALTER TABLE src REPLICA IDENTITY FULL。v0.3.0 行为说明):
pg_mooncake 0.3.0 中,对没有主键的分区表调用 mooncake.create_table 时,会自动为分区父表以及所有现有叶子子分区设置 REPLICA IDENTITY FULL(修复了早期版本中子分区 UPDATE 事件缺少完整旧元组导致复制工作进程 Panic 的缺陷)。mooncake.create_table 创建镜像之后又新增了子分区(CREATE TABLE ... PARTITION OF ...),在向该新分区执行 UPDATE 或 DELETE 之前,必须手动执行 ALTER TABLE <new_partition> REPLICA IDENTITY FULL;。TRUNCATE 行为说明
TRUNCATE 不会同步清空列存镜像表。TRUNCATE 或 DROP TABLE 会被列存镜像表有意忽略。这一设计使你可以安全地从 PostgreSQL 行存中删除历史冷分区以释放本地磁盘,同时在列存镜像中完整保留全部历史数据。详见大表分区归档指南。ALTER TABLE)
目前仅以下针对源行存表的 ALTER TABLE 操作会自动同步至列存镜像表:
ALTER TABLE <src> ADD COLUMN <col> <type>(新增列)ALTER TABLE <src> DROP COLUMN <col>(删除列)其他 DDL 变更(例如修改列类型 ALTER COLUMN ... TYPE 或重命名列 RENAME COLUMN)不会自动同步;如需执行复杂表结构变更,建议删除并重建列存镜像表(DROP TABLE <dst>; CALL mooncake.create_table('<dst>', '<src>');)。
pg_mooncake 支持所有常见的 PostgreSQL 数值、文本、布尔、日期/时间、UUID、JSON/JSONB 及常见数组类型,但以下类型暂不支持或存在限制:
ENUM)、复合类型与域类型(DOMAIN)pg_duckdb 尚未映射的几何类型与网络地址类型DECIMAL(38, s) 精度上限的超高精度 NUMERIC 值mooncake.load_files 显式报错说明(SQLSTATE 0A000)
在 pg_mooncake 0.3.0 中,调用 CALL mooncake.load_files(dst, files) 会显式返回 SQLSTATE 0A000(ERRCODE_FEATURE_NOT_SUPPORTED:"mooncake.load_files is not implemented by the bundled Moonlink version")。
import_data 处理器是一个空实现(no-op),会在未导入任何数据的情况下静默返回成功。COPY 或 INSERT INTO ... SELECT * FROM duckdb.read_parquet(...) 写入源行存表,或者参考在 Postgres 中查询外部数据湖直接就地查询外部文件。本节提供 pg_mooncake(v0.3.0) 暴露的全部 SQL 存储过程、表状态查询函数、表访问方法(TAM)以及 PostgreSQL GUC 配置参数的完整参考。
mooncake Schema)
| 对象名称 | 完整函数签名 | 功能说明 |
|---|---|---|
mooncake.create_table |
CALL mooncake.create_table(dst text, src text, src_uri text DEFAULT NULL, table_config json DEFAULT NULL) |
创建只读的 USING mooncake 列存镜像表(dst),从当前本地数据库或远程 PostgreSQL URI(src_uri)中的源表(src)实时复制数据。 |
mooncake.create_snapshot |
CALL mooncake.create_snapshot(dst text) |
等待 Moonlink 追平当前 PostgreSQL WAL 写入 LSN,将内存 Arrow 写缓冲区刷盘为 Parquet,并写入新的 Apache Iceberg v2 元数据快照。 |
mooncake.optimize_table |
CALL mooncake.optimize_table(dst text, mode text) |
对目标列存镜像表 dst 执行文件合并(Compaction)与删除向量清理(mode 支持 'full' 或 'minor')。 |
mooncake.list_tables |
SELECT * FROM mooncake.list_tables() |
表值函数,返回当前数据库中所有活跃 Moonlink 表的 (table text, commit_lsn pg_lsn, flush_lsn pg_lsn, iceberg_warehouse_location text)。 |
mooncake.load_files |
CALL mooncake.load_files(dst text, files text[]) |
在 v0.3.0 中未实现;调用时会显式抛出 SQLSTATE 0A000(FEATURE_NOT_SUPPORTED),避免旧版静默空操作造成的误导。 |
mooncake.list_tables() 返回列说明
| 列名 | 数据类型 | 说明 |
|---|---|---|
table |
text |
列存镜像表的带 Schema 完整名称(例如 public.orders_analytics)。 |
commit_lsn |
pg_lsn |
已摄取进入 Moonlink 内存 Arrow 写缓冲区的最新 PostgreSQL WAL LSN。 |
flush_lsn |
pg_lsn |
已持久化刷盘至 Parquet / Iceberg 快照存储的最新 PostgreSQL WAL LSN。 |
iceberg_warehouse_location |
text |
存放该表 Apache Iceberg v2 元数据与 Parquet 数据文件的本地目录($PGDATA/pg_mooncake/...)或云端路径(s3://...)。 |
USING mooncake):由 mooncake.create_table 自动创建,并在扩展加载时通过 RegisterDuckdbTableAm("mooncake") 注册至 pg_duckdb 1.2.0。mooncake_drop_trigger):当对列存镜像表执行 DROP TABLE <dst>; 时,ON sql_drop 事件触发器(mooncake_drop_trigger_func)会自动从 Moonlink 注销该表并清理对应的逻辑复制订阅。| 参数名称 | 类型 | 默认值 | 上下文 | 参数说明 |
|---|---|---|---|---|
mooncake.default_bucket |
string |
''(本地 $PGDATA/pg_mooncake) |
USERSET / SUSET |
新创建的 Mooncake 表写入 Parquet 数据文件与 Apache Iceberg v2 元数据的默认对象存储桶路径(例如 's3://my-bucket/warehouse')。 |
mooncake.extension_repository |
string |
$(pg_config --sharedir)/extension/pg_mooncake |
SUSET |
存放随包安装的 v2.0.0/<platform>/mooncake.duckdb_extension 二进制文件的本地扩展仓库目录。 |
mooncake.enable_local_cache |
bool |
true |
SUSET |
写入云端对象存储时是否启用本地磁盘缓存。 |
duckdb.allow_community_extensions |
bool |
false(必须设为 true) |
SUSET |
pg_duckdb 要求开启此项以允许 pg_mooncake 加载 mooncake 存储扩展。 |
duckdb.allow_unsigned_extensions |
bool |
false(必须设为 true) |
SUSET |
允许 pg_duckdb 从本地 mooncake.extension_repository 加载编译生成的 mooncake.duckdb_extension。 |
duckdb.max_memory |
string |
4GB(或可用内存 80%) |
SUSET |
分配给内嵌 DuckDB 2.0 向量化执行引擎的最大内存上限。 |
duckdb.threads |
int |
-1(全部 CPU 核心) |
SUSET |
DuckDB 2.0 用于并行向量化查询执行的工作线程数。 |
详解本地与远程(src_uri)复制、初始快照拷贝选项、分区表支持以及 table_config JSON 参数。
支持的分析型 SQL 查询形态、聚合与过滤、行存混合关联,以及在 PostgreSQL 中暴露 DuckDB 原生函数。
配置 AWS S3 与 Cloudflare R2 密钥、生成 Iceberg v2 快照,并从外部计算引擎直接读取 Mooncake 表。
在 PostgreSQL 内直接扫描外部 Parquet、CSV、JSON、Iceberg、Delta Lake 及 HuggingFace 数据集。
在 pg_mooncake 中,列存表通过 mooncake.create_table 存储过程创建,作为现有 PostgreSQL 行存表(普通堆表或分区表)的**实时同步镜像(Columnstore Mirror)**运行。
| 参数名称 | 类型 | 默认值 | 参数说明 |
|---|---|---|---|
dst |
text |
(必填) | 要创建的目标列存镜像表名称(支持 schema.table 格式,未指定 Schema 时默认为 public)。 |
src |
text |
(必填) | 作为复制源的 PostgreSQL 行存表或分区父表名称(支持 schema.table 格式)。 |
src_uri |
text |
NULL |
当从外部远程 PostgreSQL 实例复制时,指定远程连接串(postgresql://user:pass@host:port/dbname)。为 NULL 时默认从当前本地数据库复制。 |
table_config |
json |
NULL |
可选的 JSON 配置对象,用于定制 Moonlink 表级摄取与存储参数(例如 write_buffer_size)。 |
src_uri(而非 source_uri)上游早期 v0.2 文档中存在一处笔误,将远程连接参数写成了 source_uri => 'postgresql://...'。在 pg_mooncake 的真实 SQL 定义(src/functions.rs)中,该参数的准确名称为 src_uri。使用命名参数调用时请务必传入 src_uri => 'postgresql://...'。
省略 src_uri(或传 NULL)时,pg_mooncake 直接镜像当前数据库内的 src 表:
执行 CALL mooncake.create_table('orders_analytics', 'orders') 时后台完成的步骤:
pg_mooncake 读取 orders 的列结构,并创建 CREATE TABLE orders_analytics (...) USING mooncake。orders 没有主键,pg_mooncake 会自动执行 ALTER TABLE orders REPLICA IDENTITY FULL(在 v0.3.0 中,若 orders 是分区表,还会自动为所有现有叶子子分区设置 REPLICA IDENTITY FULL)。moonlink 建立逻辑复制槽(pgoutput),完成 orders 存量行的初始快照拷贝,并开始实时流式同步后续的 INSERT、UPDATE 与 DELETE 变更。src_uri)
你可以在独立的分析型 PostgreSQL 节点上部署 pg_mooncake,并通过 src_uri 实时镜像远程生产 PostgreSQL 数据库(包括自建实例、AWS RDS、Aurora、Supabase 或 Neon)中的业务表:
远程源数据库需满足以下条件:
wal_level = logical。src_uri 中的数据库用户具备 REPLICATION 权限以及源表 src 的 SELECT 权限。REPLICA IDENTITY FULL。mooncake.create_table 原生支持 PostgreSQL 声明式分区表(PARTITION BY RANGE、LIST 或 HASH)。调用时只需将分区父表名称作为 src 传入:
create_table 之后新增子分区的注意事项在 pg_mooncake 0.3.0 中,mooncake.create_table 会自动为创建镜像时已存在的所有叶子子分区设置 REPLICA IDENTITY FULL。如果在创建镜像之后又新增了子分区(例如 CREATE TABLE events_2026_12 PARTITION OF events ...)且表没有主键,请在对新分区执行 UPDATE 或 DELETE 前手动执行 ALTER TABLE events_2026_12 REPLICA IDENTITY FULL;。
table_config 参数配置
你可以通过 table_config 传入 JSON 对象来定制单表级 Moonlink 行为(对应 moonlink_backend/src/table_config.rs 中的 TableConfig 结构),包括纯追加(Append-Only)模式、后台合并开关,以及自定义本地文件系统 / S3 / GCS 存储后端:
| JSON 字段路径 | 类型 | 默认值 | 参数说明 |
|---|---|---|---|
mooncake.append_only |
bool |
false |
设为 true 时将表视为纯追加模式,跳过维护主键哈希索引以提升写入吞吐。 |
mooncake.skip_index_merge |
bool |
false |
设为 true 时禁用后台 Puffin 哈希索引 LSM 树合并。 |
mooncake.skip_data_compaction |
bool |
false |
设为 true 时禁用后台 Parquet 数据文件自动合并(Compaction)。 |
iceberg.storage_config |
object |
{"fs": {"root_directory": "$PGDATA/pg_mooncake"}} |
Apache Iceberg v2 元数据与 Parquet 数据文件的存储后端(支持 fs、s3 或 gcs)。 |
wal.storage_config |
object |
{"fs": {"root_directory": "$PGDATA/pg_mooncake"}} |
Moonlink 内部 WAL 日志段的存储后端(支持 fs、s3 或 gcs)。 |
如需删除列存镜像表并自动清理其 Moonlink 元数据与逻辑复制槽,直接执行标准的 DROP TABLE 即可:
通过 CALL mooncake.create_table(dst, src) 创建的列存镜像表可以直接使用标准 PostgreSQL SELECT 语法进行查询。在底层,pg_mooncake 与 pg_duckdb 1.2.0 会将分析型查询自动转换并下推至内嵌的 DuckDB v2.0.0 向量化执行引擎。
当你查询一张 USING mooncake 列存镜像表时:
duckdb_mooncake 检查当前 PostgreSQL 的 WAL 写入 LSN,并等待 moonlink 将该 LSN 之前所有已提交的事务摄取完毕。WHERE 过滤条件的文件与行组。duckdb.threads),并行融合扫描磁盘上的 Parquet 数据文件、Roaring Bitmap 删除向量以及内存中的 Apache Arrow 写缓冲区。你可以通过 EXPLAIN 验证查询是否已由 DuckDB 接管执行:
列存镜像表专为扫描海量行、读取部分列的 OLAP 分析负载设计,相比传统 PostgreSQL 堆表通常可获得 10× 至 1000× 的查询加速。
你可以在同一条 SQL 中将 USING mooncake 列存镜像表与常规 PostgreSQL 行存表(如维度表、字典表)直接关联:
虽然 pg_mooncake 支持任意 SELECT 语句,但针对单行主键点查(WHERE id = 12345)或极小范围索引扫描,应当直接查询源行存表(利用 PostgreSQL 的 B-Tree 索引获得亚毫秒级响应):
由于针对 USING mooncake 表的查询由 DuckDB(pg_duckdb)执行,部分没有 DuckDB 直接对应实现的 PostgreSQL 特有函数(例如 to_char()、部分 regexp_* 重载或特定 jsonb_* 操作符)可能需要改写为兼容表达式。
如果你希望在查询列存镜像表时调用 DuckDB 内置的分析函数(例如时序分桶函数 time_bucket),只需在 PostgreSQL 中定义一个同签名的占位 PL/pgSQL 函数。当查询下推至 DuckDB 时,pg_duckdb 会自动将其绑定到 DuckDB 的原生向量化实现:
pg_mooncake(v0.3.0)中的每一张列存镜像表均由 moonlink 驱动,底层数据存储为标准的 Parquet 文件,并自动维护 Apache Iceberg v2 表元数据。
默认情况下,Moonlink 将文件保存在本地数据目录 $PGDATA/pg_mooncake/ 下。你可以配置 pg_mooncake 直接将数据写入 Amazon S3、Cloudflare R2、MinIO 或 Google Cloud Storage (GCS),从而让外部数据湖计算引擎(DuckDB、Apache Spark、Trino、Snowflake、PyIceberg)直接从对象存储读取你的 PostgreSQL 表数据。
duckdb.secrets)
pg_mooncake 从 pg_duckdb 的 duckdb.secrets 表中读取对象存储凭据,并自动将其同步提供给 Moonlink 与 DuckDB。
table_config 与 mooncake.default_bucket)
在 pg_mooncake v0.3.0 中,你可以通过 mooncake.create_table 的第四个参数 table_config 直接为表指定 S3 / R2 / GCS 存储后端(或参考上游 v0.1/v0.2 文档中的 mooncake.default_bucket 设置):
在 PostgreSQL 数据库内部查询 orders_analytics 时,会自动融合扫描已刷盘的 Parquet 文件与 Moonlink 内存中的 Arrow 写缓冲区;但外部 Iceberg 计算引擎只能看到已刷盘写入 Iceberg 元数据快照的数据。
如需强制将当前 PostgreSQL WAL LSN 之前所有已提交的数据刷盘,并生成新的 v*.metadata.json 快照文件,请调用:
v0.3.0(moonlink v0.0.1)非阻塞快照修复在 pg_mooncake 0.3.0 中,即使自上一次对 orders 表写入之后,数据库因其他无关表的写入推进了全局 WAL LSN,调用 CALL mooncake.create_snapshot('orders_analytics') 也能立即完成刷盘并返回,不会发生阻塞挂起。
使用 mooncake.list_tables() 查看当前的提交 LSN、刷盘 LSN 以及准确的 iceberg_warehouse_location 路径:
示例输出:
在 iceberg_warehouse_location 目录下,Moonlink 会维护标准的 Apache Iceberg v2 元数据(metadata/v1.metadata.json、v2.metadata.json 等):
mooncake.optimize_table)
如需将多个小 Parquet 文件合并为大文件,并将 Roaring Bitmap 删除向量重写合并至基础数据文件中,可调用:
由于 pg_mooncake(v0.3.0)通过 pg_duckdb 1.2.0 内嵌了 DuckDB v2.0.0 引擎,你可以在不将数据事先导入本地堆表的情况下,直接从 PostgreSQL 查询外部数据湖(本地磁盘、AWS S3、Cloudflare R2、GCS、HTTP 或 HuggingFace hf:// 数据集)中的文件。
duckdb.read_parquet)duckdb.read_csv)duckdb.read_json)duckdb.iceberg_scan)duckdb.delta_scan)v0.2 / v0.3(duckdb.*)与旧版 v0.1(mooncake.*)函数区别在 pg_mooncake v0.2 与 v0.3.0 中,外部文件读取函数由 pg_duckdb 直接提供(即 duckdb.read_parquet、duckdb.read_csv、duckdb.iceberg_scan、duckdb.delta_scan)。如果你需要查阅旧版 v0.1 的 mooncake.read_parquet 语法,请参阅 v0.1 查询外部文件。
duckdb.read_parquet)
调用 duckdb.read_parquet 并在 AS (...) 子句中声明返回的列结构:
也支持直接扫描按 Hive 分区目录组织的文件集合:
duckdb.read_csv)
首先通过 duckdb.install_extension 安装并启用 DuckDB 的 iceberg 或 delta 扩展:
你可以在单条 SQL 查询中将外部 Parquet、Iceberg 或 Delta Lake 数据集与 PostgreSQL 普通行存表或 USING mooncake 列存镜像表直接 JOIN:
hf://)
DuckDB 原生支持通过 hf://datasets/<org>/<repo>/<path> 协议直接流式读取公开的 HuggingFace 数据集:
无需引入 Kafka、Debezium 或外部独立数仓,pg_mooncake 即可在 PostgreSQL 内部直接支撑以下四种高价值分析架构模式:
业务继续写入主 OLTP 行存表,将慢速聚合报表查询路由至亚秒级同步的 USING mooncake 列存镜像表。
为按时间分区的 PostgreSQL 大表创建列存镜像,定期从行存中 DROP 旧分区释放昂贵磁盘空间,同时在列存中完整保留可随时查询的全部历史数据。
自动将 PostgreSQL 业务表导出为 S3 或 Cloudflare R2 上的标准 Apache Iceberg v2 表,并在 Postgres 内直接查询外部 Iceberg / Delta Lake 数据集。
在 PostgreSQL 中承载海量应用日志与链路追踪事件,基于对象存储 Parquet 文件实现低成本、高吞吐的向量化聚合查询。
如果你正在 PostgreSQL 业务表上运行缓慢的分析查询(例如实时报表看板、面向客户的统计指标、多维聚合查询),pg_mooncake 提供了一条极简的加速路径:
CALL mooncake.create_table(dst, src) 创建实时列存镜像表。SELECT 查询路由至列存镜像表(往往无需修改 SQL 语句本身)。ALTER TABLE ... ADD COLUMN 与 DROP COLUMN 操作会自动同步至列存镜像表。UPDATE 与 DELETE:moonlink 结合内存 Apache Arrow 写缓冲区与 Roaring Bitmap 删除向量,处理高频更新与删除的性能远超传统 Parquet / Iceberg 写入方案。pg_mooncake 不会自动拦截针对 orders 的查询并将其改写到 orders_analytics。请根据查询负载类型显式选择目标表:
这种显式读写分离让你能够完全掌控数据库性能:事务操作在拥有 B-Tree 索引的行存堆表上保持亚毫秒级响应,而大吞吐分析扫描则充分发挥 DuckDB 2.0 在列存上的向量化执行优势。
pg_mooncake 的列存镜像表将数据写为高压缩比的 Parquet 文件(保存在本地磁盘或 AWS S3 / Cloudflare R2 对象存储上),使你能够在 PostgreSQL 行存中仅保留近期热分区,同时在列存镜像中以极低成本持久化保留完整的历史数据。
分区冷热归档模式遵循以下三条核心原则:
CALL mooncake.create_table)。DROP 或 TRUNCATE 过期旧分区,立即释放昂贵的本地 NVMe / SSD 空间,避免 VACUUM FULL 锁表开销。pg_mooncake 会有意忽略针对分区源表子分区的 DROP TABLE 与 TRUNCATE 事件,因此被删除分区的历史行依然完整保留在列存镜像中并可随时查询!下面以一张按范围分区的 transactions 交易流水表为例演示完整归档流程。
当 transactions_p1 变为历史冷数据、需要回收 PostgreSQL 本地磁盘空间时:
尽管 transactions_p1 已从行存中删除,但它的全部历史记录依然完好地保存在 transactions_archive 中:
pg_mooncake 专门针对分区子表的 DROP / TRUNCATE 做了归档保留处理。mooncake.default_bucket = 's3://...',即可将所有历史 Parquet 文件与 Iceberg 元数据直接存储在廉价的云端对象存储上。详见 Iceberg 与对象存储配置。**湖仓一体(Lakehouse)**架构将数据以开放表格式(Apache Iceberg 或 Delta Lake)统一存储在对象存储上,使多个计算引擎——PostgreSQL、DuckDB、Apache Spark、Snowflake、Trino 以及 Python(Polars / PyIceberg)——能够共享同一份数据,而无需反复拷贝。
pg_mooncake 让 PostgreSQL 在双向数据流中都成为湖仓架构的一等公民:
moonlink 将在线 PostgreSQL 业务表实时复制为 AWS S3、Cloudflare R2 或本地存储上的标准 Apache Iceberg v2 表。pg_duckdb 在 PostgreSQL 内直接扫描外部 Parquet、Apache Iceberg 与 Delta Lake 表,并与在线业务表实时 JOIN。在传统架构中,将 PostgreSQL 数据同步到 Apache Iceberg 需要部署 Debezium、Kafka、Schema Registry 以及 Spark/Flink 消费作业。使用 pg_mooncake,只需三条 SQL 命令:
通过 SELECT * FROM mooncake.list_tables(); 查看生成的仓库路径后,Spark、Snowflake、Trino 或 PyIceberg 即可直接读取 <iceberg_warehouse_location>/metadata/v*.metadata.json。
与此同时,你的 PostgreSQL 应用也可以直接查询由外部 Spark 或机器学习流水线写入 S3 的 Iceberg 表,并与本地实时行存表直接关联:
在传统架构中,人们很少使用 PostgreSQL 承载大规模日志分析,因为行存堆表与索引的磁盘占用增长极快,且对数千万条日志执行全表聚合扫描非常缓慢。
借助 pg_mooncake,你可以将按时间分区的 PostgreSQL 行存写入与基于对象存储的列存镜像结合起来:
使用按天/按小时分区的行存表承接实时日志写入,并创建 USING mooncake 列存镜像表执行聚合检索:
当每日日志分区超过热保留窗口(例如 24 或 48 小时后),可按照大表分区冷热归档模式直接从行存中删除旧分区(DROP TABLE application_logs_2026_11_01;),而完整的历史日志依然保留在 application_logs_analytics 中供长期回溯分析。
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
pg_mooncake v0.1 是第一代 PostgreSQL 列存扩展,通过 USING columnstore 表访问方法与底层的 Delta Lake + DuckDB(pg_duckdb)提供分析加速。
v0.1 版本核心特性
USING columnstore 表上执行事务型 INSERT、UPDATE 与 DELETEUSING columnstore 表之间的直接关联查询v0.1 历史归档目录
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
在 pg_mooncake v0.1 中,表级事务元数据保存在 PostgreSQL 系统目录中以保证事务一致性,而列存数据本身则以 Parquet 文件与 Delta Lake 元数据形式存储在本地文件系统或云端对象存储中。
列存表作为 PostgreSQL 表访问方法(USING columnstore)暴露给用户,查询通过 pg_duckdb 路由至 DuckDB 执行。
涉及 USING columnstore 表的查询由 PostgreSQL 路由至 DuckDB 执行,并在内部自动处理轻微的 SQL 语法差异转换。
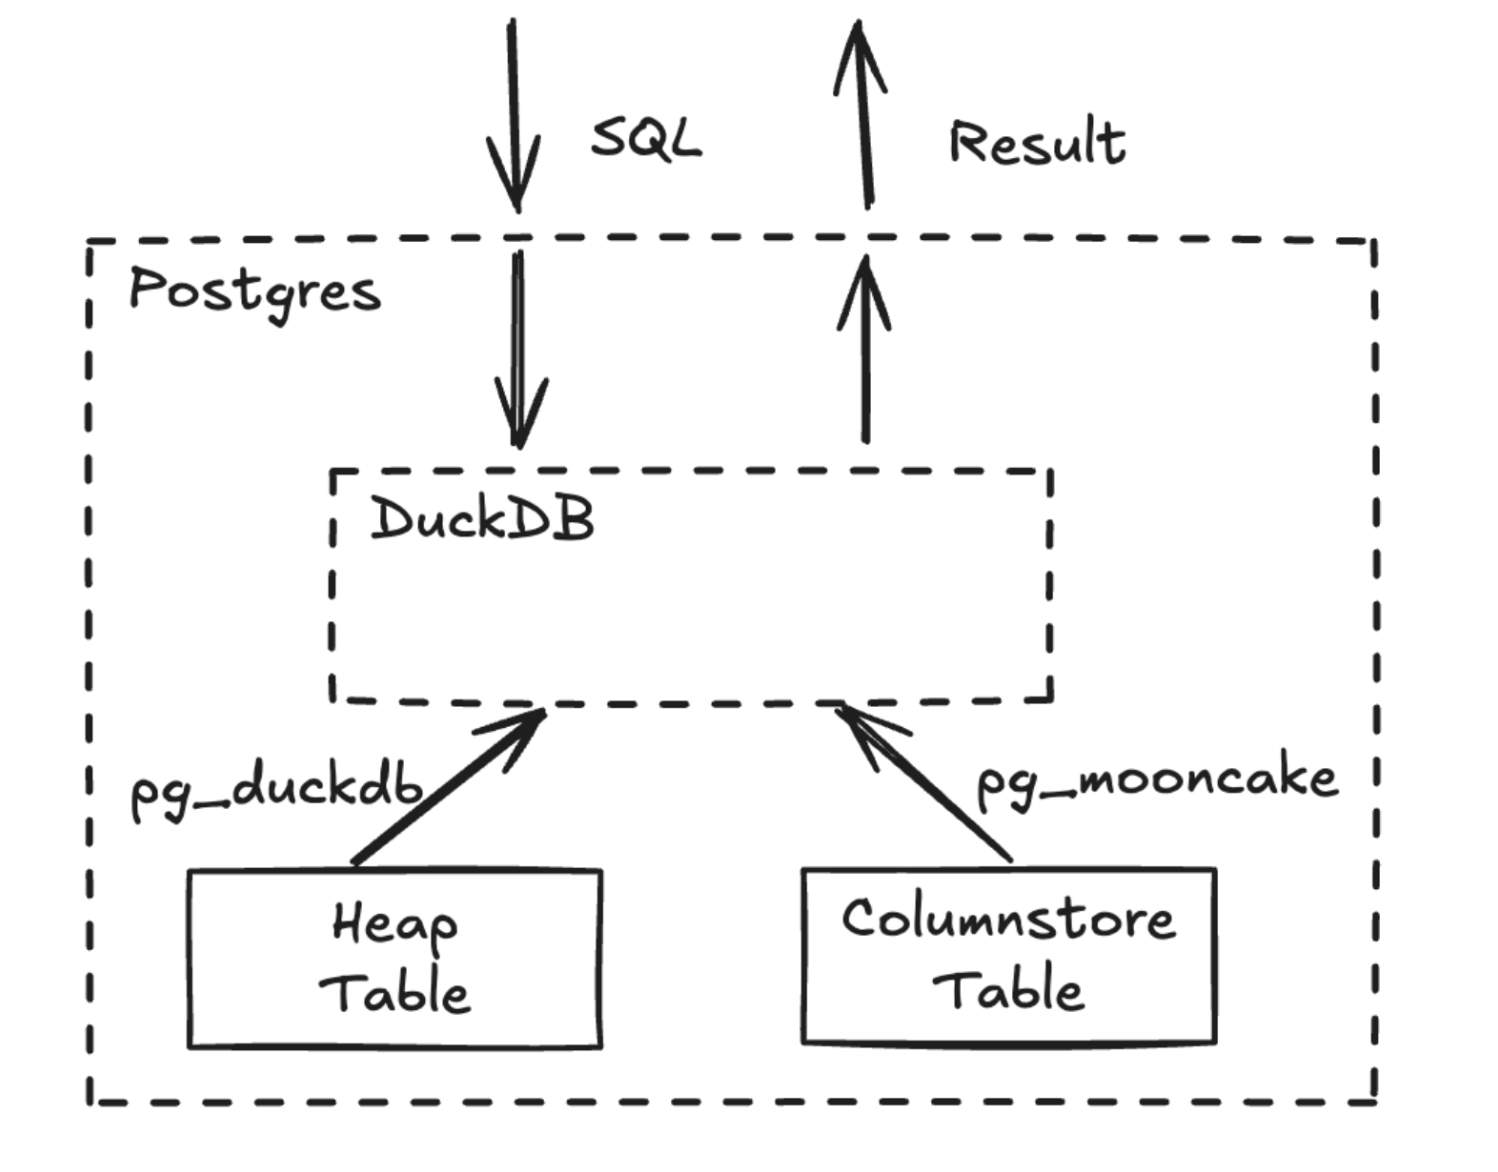
pg_mooncake v0.1 将 Parquet 文件元数据与列级统计信息缓存在 PostgreSQL 表(mooncake.data_files)中,并在扫描时利用统计信息实现分段跳过(Segment Elimination)。
在 v0.1 中,用户直接在 USING columnstore 表上运行事务型 INSERT、UPDATE 与 DELETE。为了支持更新与删除,表扫描期间会填充由 (file_id, row_offset) 组成的隐式 row_id 列。
每次写入操作都会生成一个新的 Parquet 文件,因此 v0.1 更适合大批量写入(单批次 100,000–1,000,000 行),而不适合高频小事务写入。
写入时数据默认缓存在本地磁盘(mooncake.enable_local_cache = true),从而显著加速对近期写入热数据的分析查询。
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
v0.1
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
USING columnstore 列存表(v0.1)
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
v0.3.0 对象存储配置方式在 v0.2 与 v0.3.0 中,对象存储凭据通过 duckdb.secrets 表管理,不再使用 mooncake.create_secret。最新说明请参阅 Iceberg 与对象存储配置。
v0.1)
针对 S3 Express 存储桶:
v0.1)
| 参数名 | 说明 | 是否必填 |
|---|---|---|
name |
凭据名称 | 是 |
key_id |
S3 / R2 Access Key ID | 是 |
secret |
S3 / R2 Secret Access Key | 是 |
REGION |
S3 存储桶所在区域 | 是 |
ENDPOINT |
R2 或 S3 Express 自定义端点 | 是(R2 / S3 Express) |
SCOPE |
凭据生效的存储桶路径前缀(如 s3://mybucket) |
否 |
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
pg_mooncake v0.1 曾作为实验性扩展提供在 Neon 托管平台上。
v0.1)
由于 Neon 计算节点不支持将列存文件持久化在本地磁盘,在 Neon 上使用 pg_mooncake v0.1 必须按 v0.1 对象存储配置 绑定外部 S3 或 R2 存储桶,并建议关闭 Scale-to-Zero 以保留本地缓存。
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
v0.1)
在 v0.1 中,列存表通过在 CREATE TABLE 时附加 USING columnstore 子句直接创建:
v0.1 支持的特性与限制
INSERT、UPDATE、DELETE、ACID 事务、NOT NULL 约束、默认值以及与行存表的关联查询。v0.1 不支持的数据类型:ENUM、uhugeint、JSONB(早期受限)以及部分数组类型。v0.1 不支持的约束:主键、外键、唯一约束、索引以及分区表(修改表结构需重建表)。columnstore 设为默认表访问方法(v0.1)
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
v0.3.0 元数据查询函数在 v0.2 与 v0.3.0 中,请使用 SELECT * FROM mooncake.list_tables(); 查看表 LSN 进度与 Apache Iceberg v2 仓库路径。
v0.1)
在 v0.1 中,mooncake.columnstore_tables 目录表记录了每张 USING columnstore 表的 Delta Lake 存储路径:
v0.1)
v0.1 Delta Lake 表
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
v0.1 GUC 参数一览
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
v0.1)
v0.1)
v0.1)
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
v0.3.0 外部文件读取方式在 v0.2 与 v0.3.0 中,请使用 duckdb.read_parquet、duckdb.read_csv、duckdb.iceberg_scan 与 duckdb.delta_scan,详见在 Postgres 中查询外部数据湖。
v0.1)
v0.1)
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
关于 v0.3.0 与 DuckDB 2.0 的最新查询形态指南,请参阅查询列存表与查询形态。
v0.1)
v0.1)
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
v0.3.0 分区冷热归档方案在 v0.2 与 v0.3.0 中,无需再手动编写 INSERT INTO ... DELETE FROM 迁移脚本,只需对分区表调用 CALL mooncake.create_table 并直接 DROP 旧分区即可。详见大表分区冷热归档。
v0.1 数据归档方式
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
v0.2 / v0.3.0 中已由 mooncake.create_table 彻底取代在 v0.1 中,将行存表同步至 USING columnstore 表需要手动维护触发器、暂存表与 pg_cron 定时任务。在 v0.2 与 v0.3.0 中,只需一行 CALL mooncake.create_table('orders_analytics', 'orders'); 即可实现亚秒级逻辑复制。详见实时操作分析 (HTAP)。
v0.1 历史暂存表与触发器同步模式
pg_mooncake v0.1 历史归档文档(Delta Lake 引擎)本页归档的是早期 pg_mooncake v0.1 版本文档(采用直接 CREATE TABLE ... USING columnstore DDL 与 Delta Lake 存储)。从 v0.2 及 PGSTY 维护的 v0.3.0 版本起,pg_mooncake 已全面转向基于 moonlink 的实时列存镜像架构(CALL mooncake.create_table + USING mooncake)与 Apache Iceberg v2。最新文档请参阅简介与 v0.1 与 v0.2 / v0.3 架构演进对比。
v0.1)
v0.1)
在 v0.1 中,可以通过在 dbt 的 on-run-start 钩子中设置 default_table_access_method = 'columnstore' 让 dbt 模型默认创建列存表:
mooncake.pgsty.com 是 PGSTY 维护的 Mooncake(面向 PostgreSQL 与 DuckDB 的实时分析生态)分支项目的伴生文档与工程站点:
| 代码仓库 | 当前标签 | 许可证 | 上游来源 | 说明 |
|---|---|---|---|---|
pgsty/pg_mooncake |
v0.3.0 |
MIT |
Mooncake-Labs/pg_mooncake |
PostgreSQL 列存表扩展(基于 pgrx 0.19.3 与 pg_duckdb 1.2.0)。 |
pgsty/duckdb_mooncake |
v0.0.2 |
MIT |
Mooncake-Labs/duckdb_mooncake |
挂载 Moonlink 实时 Iceberg 表的 DuckDB 2.0.0 存储扩展。 |
pgsty/moonlink |
v0.0.1 |
BSL-1.1 + 链接豁免(客户端 crate 为 MIT) |
Mooncake-Labs/moonlink |
将实时流式更新与 CDC 摄入 Apache Iceberg 与 Parquet 的 Rust 引擎。 |
上游 v0.2 历史特性路线图与当前 PGSTY 分支的工程维护重点(v0.3.0+)。
MIT、带 pg_mooncake 链接与分发豁免的 BSL-1.1,以及 CC-BY-4.0 文档许可协议。
Mooncake Labs 原始团队致谢、Wayback Machine 文档恢复说明与代码仓库演进脉络。
商标归属说明与 PGSTY 分支的独立维护声明。
子模块版本矩阵(versions.json)与 2026-11-05 Cargo RustSec 依赖安全审计报告。
下方路线图保留了上游 docs.mooncake.dev/pg/roadmap 发布的 pg_mooncake v0.2 历史设计规划,并补充了当前 pgsty/pg_mooncake(v0.3.0)分支的长期工程维护重点。
v0.3.0+)
PGSTY 维护的 Mooncake 套件(pg_mooncake v0.3.0、duckdb_mooncake v0.0.2、moonlink v0.0.1)专注于生产环境长期可用性、PostgreSQL 大版本覆盖与依赖安全加固:
pg_mooncake 与最新 pgrx(0.19.3)同步,覆盖 Linux(x86_64 与 aarch64、RHEL/Rocky EL8–EL10、Debian 12/13、Ubuntu 22.04/24.04)上的 PostgreSQL 14、15、16、17 与 18。2.0.0 与 pg_duckdb 1.2.0 同步演进:随着 DuckDB 的 TableCatalogEntry、TableFilterSet 与 StorageExtension C++ 接口演进,持续维护 pg_mooncake、pg_duckdb 与 duckdb_mooncake 之间的 ABI 兼容性。pg_duckdb 运行时版本校验、列存表 LSN 一致性快照读取、分区表层级自动设置 REPLICA IDENTITY FULL,以及对已弃用辅助函数显式抛出 0A000 错误。pg_mooncake、moonlink、duckdb_mooncake/moonlink_ffi)中的 Rust 依赖项。v0.2)
以下四项特性是 Mooncake Labs 针对 v0.2 架构规划的演进方向:
为 columnstore 表引入**仅追加(append-only)**模式:
直接创建并写入 columnstore 表,而无需依赖配套的 PostgreSQL 行存堆表:
columnstore 表访问方法执行标准 INSERT、SELECT、UPDATE、DELETE 与 COPY;USING columnstore 表在 v0.1(Delta Lake 架构)中可用,而 v0.2 与 v0.3.0 采用 mooncake.create_table(dst, src) 通过逻辑复制镜像 PostgreSQL 行存表。在 PostgreSQL 中创建能够直接写入外部现有 Apache Iceberg 表(由 REST 或 JDBC Catalog 管理)的 columnstore 镜像表,实现与 Spark、Trino、Flink 写入端的双向互通。
在行存 + 列存混合分区表层级上透明路由分析查询,无需手写 UNION ALL 或显式引用双表名称。
PGSTY Mooncake 生态完整保留了 Mooncake Labs, Inc. 为各个代码仓库设定的上游许可证条款。
| 组件 | 代码仓库 | 许可证 | 说明 |
|---|---|---|---|
pg_mooncake |
pgsty/pg_mooncake |
MIT |
宽松开源许可证(Copyright (c) 2024 Mooncake Labs)。 |
duckdb_mooncake |
pgsty/duckdb_mooncake |
MIT |
宽松开源许可证(Copyright (c) 2025 Mooncake Labs)。 |
moonlink(核心引擎) |
pgsty/moonlink |
BSL-1.1 + 链接豁免 |
Business Source License 1.1,附带 PG_MOONCAKE LINKING & DISTRIBUTION EXCEPTION,将于 2029-05-05 自动转换为 Apache-2.0。 |
moonlink(客户端 Crate) |
moonlink_rpc、moonlink_proto、moonlink_error、moonlink_table_metadata |
MIT |
显式采用 MIT 许可,确保 pg_mooncake 与 duckdb_mooncake 链接客户端接口时保持纯 MIT 属性。 |
| 伴生文档站 | pgsty/mooncake.pgsty.com |
CC-BY-4.0 / Apache-2.0 |
文档正文采用知识共享署名 4.0 国际许可协议(CC-BY-4.0);站点构建脚本采用 Apache-2.0。 |
pg_mooncake 与 duckdb_mooncake — MIT 许可证
pg_mooncake 与 duckdb_mooncake 均采用 MIT License 发布:
moonlink — Business Source License 1.1 与 pg_mooncake 链接豁免
moonlink 采用 Business Source License 1.1 (BSL-1.1) 并附带 PG_MOONCAKE LINKING & DISTRIBUTION EXCEPTION:
moonlink (v0.0.1)2029-05-05Apache-2.0(Apache License, Version 2.0)moonlink,也可以将其集成到向第三方提供的软件应用或服务中,前提是该服务不将 moonlink 本身作为竞争性托管云服务(Managed Service / DBaaS / SaaS)向第三方直接售卖。PG_MOONCAKE LINKING & DISTRIBUTION EXCEPTION(链接与分发豁免)
由于 pg_mooncake 通过 FFI(pg_mooncake_moonlink_ffi)内嵌了 moonlink,且 duckdb_mooncake 链接了 moonlink_ffi,上游许可证专门提供了以下豁免条款:
moonlink_rpc、moonlink_proto、moonlink_error 与 moonlink_table_metadata)单独采用 MIT 许可,不属于 BSL-1.1 受限范围。moonlink(含 pg_mooncake_moonlink_ffi)与 pg_mooncake(及其任何 MIT 许可的分支或衍生作品)进行静态或动态链接,生成组合二进制文件或 PostgreSQL 扩展安装包,且不会导致 pg_mooncake 本身的源代码受制于 BSL-1.1。LICENSE 文件并遵守托管服务限制即可。pg_mooncake 在构建时还使用了 versions.json 中锁定的两个开源子模块:
pg_duckdb (v1.2.0):MIT 许可证(Copyright (c) 2024 Hydra, MotherDuck, and pg_duckdb contributors)。rust-postgres (14c8e599):Apache-2.0 OR MIT 双重许可。pg_mooncake、duckdb_mooncake 与 moonlink 由 Mooncake Labs 团队创建。所有核心架构设计——包括行存 + 列存混合表模型、Moonlink 实时 Iceberg 缓冲引擎、逻辑复制 WAL 摄入流水线以及 DuckDB 向量化执行桥接——均归属于 Mooncake Labs 原作者与社区贡献者。
| PGSTY 代码仓库 | 上游源仓库 | 上游基线提交 | PGSTY 发布标签 |
|---|---|---|---|
pgsty/pg_mooncake |
Mooncake-Labs/pg_mooncake |
v0.2.0 (be17cd0) 及后续上游提交 |
v0.3.0 (1a9cbfd65be9a6486d020120acb49ef0c6800d68) |
pgsty/duckdb_mooncake |
Mooncake-Labs/duckdb_mooncake |
ba79184 |
v0.0.2 (49765a369ad88986916ce53c969ed2ce4ba66fac) |
pgsty/moonlink |
Mooncake-Labs/moonlink |
f2e1715 |
v0.0.1 (b298ef7444890e3c8af5544e350232518bcfd8e5) |
pgsty/pg_duckdb |
duckdb/pg_duckdb |
v1.2.0 |
v1.2.0 (8756099e267c47f0b86c24de4cf995327f1f4279) |
上游原文档站点(https://docs.mooncake.dev/)在项目转型后已下线,且 GitHub 上未公开原始文档源码仓库。
为了完整保留 v0.2(Moonlink + Iceberg 架构)与 v0.1(Delta Lake 架构)的参考手册:
2025-12-07)中完整恢复了全部 34 个规范文档路径(17 页 v0.2 文档、16 页 v0.1 文档与 1 页 Moonlink 概览)、30 个早期历史路径别名以及 4 幅原始架构图。v0.3.0 源码逐项核验:所有 SQL 函数签名、GUC 配置参数、环境变量与错误码均已对照 pgsty/pg_mooncake v0.3.0 源码树(pgrx 0.19.3、pg_duckdb 1.2.0、duckdb_mooncake v0.0.2、moonlink v0.0.1)完成核验与修正。/zh/docs/),并发布了涵盖 DuckDB 2.0 适配、pgrx 0.19.3 升级以及 2026-11-05 RustSec 依赖安全审计的工程报告。所有改编自上游历史文档的页面均在 Front Matter 中标注了 upstream_source 与 upstream_link 元数据。
mooncake.pgsty.com 以及 github.com/pgsty 组织下的代码仓库(pgsty/pg_mooncake、pgsty/duckdb_mooncake、pgsty/moonlink)由 PGSTY (Pigsty) 面向 PostgreSQL 开源社区独立维护。
本站点以及由 Pigsty / PGEXT 分发的软件包与 Mooncake Labs, Inc. 不存在隶属、官方背书或商业赞助关系。
@Vonng)的商标。本页记录了 pg_mooncake v0.3.0、duckdb_mooncake v0.0.2 与 moonlink v0.0.1 的精确子模块版本矩阵(versions.json)以及 Cargo 依赖安全审计结果。
versions.json)
pgsty/pg_mooncake 在仓库根目录的 versions.json 中记录了所有子模块与上游依赖的精确提交哈希:
| 组件 | 路径 | 代码仓库 | 标签 / 分支 | Commit SHA | 许可证 |
|---|---|---|---|---|---|
pg_mooncake |
/ |
pgsty/pg_mooncake |
v0.3.0 |
1a9cbfd65be9a6486d020120acb49ef0c6800d68 |
MIT |
duckdb_mooncake |
duckdb_mooncake |
pgsty/duckdb_mooncake |
v0.0.2 |
49765a369ad88986916ce53c969ed2ce4ba66fac |
MIT |
duckdb(嵌套子模块) |
duckdb_mooncake/duckdb |
duckdb/duckdb |
v2.0.0 |
d54cbbe3df17e8e5ce68312f483b4155836112aa |
MIT |
moonlink |
moonlink (duckdb_mooncake/moonlink) |
pgsty/moonlink |
v0.0.1 |
b298ef7444890e3c8af5544e350232518bcfd8e5 |
BSL-1.1 + 豁免(客户端 crate 为 MIT) |
pg_duckdb |
pg_duckdb |
pgsty/pg_duckdb |
v1.2.0 |
8756099e267c47f0b86c24de4cf995327f1f4279 |
MIT |
rust-postgres |
rust-postgres |
sfackler/rust-postgres |
master |
14c8e599f5551a8caa96ff5023685a6f537a1455 |
Apache-2.0 OR MIT |
| 依赖项 | 版本 | 职责说明 |
|---|---|---|
pgrx / cargo-pgrx |
0.19.3 |
Rust PostgreSQL 扩展开发框架(支持 PostgreSQL 14–18)。 |
iceberg |
0.6.0 |
moonlink 中的 Apache Iceberg 表元数据与 Catalog 客户端。 |
arrow / parquet |
55.2.0 |
moonlink 中的列式内存格式与 Parquet 文件写入器。 |
datafusion |
48.0.1 |
moonlink 中的表达式求值与谓词裁剪引擎。 |
opendal |
0.53.1 |
统一对象存储抽象层(支持 fs、s3、gcs、azblob)。 |
tonic / prost |
0.14.5 / 0.14.3 |
pg_mooncake 与 moonlink 之间的 gRPC / IPC 协议序列化。 |
tokio |
1.53.0 |
后台数据摄入与对象存储 I/O 的异步运行时。 |
我们使用 cargo-audit 0.22.2 对照 RustSec 漏洞数据库(commit 965bf9ad083b58e6340d65829d85217b18be9290,共加载 927 条安全公告)对全部三个 Cargo 工作区进行了审计与修复。
| 锁文件 | 修复前 | 修复后 | 降幅 |
|---|---|---|---|
pg_mooncake/Cargo.lock |
33 个漏洞、1 个 unsound、19 条警告 | 6 个漏洞、0 个 unsound、15 条警告 | 漏洞减少 27 个(-82%),unsound 清零 |
moonlink/Cargo.lock |
46 个漏洞、1 个 unsound、28 条警告 | 15 个漏洞、0 个 unsound、24 条警告 | 漏洞减少 31 个(-67%),unsound 清零 |
duckdb_mooncake/moonlink_ffi/Cargo.lock |
1 个漏洞、0 个 unsound、0 条警告 | 0 个漏洞、0 个 unsound、0 条警告 | -100%(完全清零) |
tonic 0.12 -> 0.14.5、prost 0.13 -> 0.14.3(消除了 RUSTSEC-2026-0001 rkyv 内存耗尽 DoS 以及 duckdb_mooncake 中的 RUSTSEC-2024-0436 paste 停更警告)。bincode 1.3.3 -> 2.1.0(启用 serde 兼容路径,修复 RUSTSEC-2025-0141)。opentelemetry 0.27 -> 0.31.0、opentelemetry-otlp 0.27 -> 0.31.1、tracing-opentelemetry 0.28 -> 0.32.1。reqwest 0.12.20 -> 0.12.28;通过升级 testcontainers 0.23.3 -> 0.27.2 彻底移除存在 PAX 头解析漏洞(RUSTSEC-2025-0065)的 tokio-tar。bytes 1.10.1 -> 1.11.1(RUSTSEC-2026-0007:BytesMut::reserve 整数溢出)。quinn-proto 0.11.12 -> 0.11.14(RUSTSEC-2026-0037:Quinn 端点拒绝服务漏洞)。rustls 0.23.28 -> 0.23.37 与 rustls-webpki 0.103.3 -> 0.103.12(RUSTSEC-2026-0049、RUSTSEC-2026-0098、RUSTSEC-2026-0099:CRL 分发点与通配符名称约束校验修复)。aws-lc-rs 1.13.1 -> 1.16.3 与 aws-lc-sys 0.29.0 -> 0.39.1(修复 7 项 PKCS7 / AES-CCM / X.509 侧信道与逻辑漏洞)。lz4_flex 0.11.4 -> 0.11.6(RUSTSEC-2026-0041:内存信息泄露)。tar 0.4.44 -> 0.4.45(RUSTSEC-2026-0067 与 RUSTSEC-2026-0068:PAX 大小头处理与符号链接权限漏洞)。time 0.3.41 -> 0.3.47(RUSTSEC-2026-0009:RFC 2822 解析栈耗尽 DoS)。wasmtime 29.0.1 -> 43.0.1(修复 12 项 WASI/Wasmtime 沙箱漏洞及 regalloc2 内存安全问题)。glib 0.20.12 -> 0.22.4(消除 RUSTSEC-2026-0097 VariantStrIter unsound 问题)。pg_mooncake/Cargo.lock 中剩余的 6 条通告均来自 iceberg 0.6.0(锁定了 arrow 55、parquet 55、avro-schema 0.3 与旧版传递依赖)以及 moonlink 中的 deltalake-core 0.26.0:
rsa 0.9.10(RUSTSEC-2023-0071):由 iceberg-catalog-sql -> sqlx-mysql 传递引入,moonlink 运行时仅初始化 PostgreSQL/REST Iceberg Catalog,不触发 MySQL RSA 握手机制。md5 0.7.0(RUSTSEC-2025-0146,已更名为 md-5):由 avro-schema 0.3.0 引入。snappy 0.4.0(RUSTSEC-2026-0046,超大缓冲区 >4 GiB 时的整数截断):由 avro-schema 0.3.0 引入,而 Iceberg Avro 清单文件通常仅为 KB 到 MB 级别。rustls-webpki 0.102.8(RUSTSEC-2026-0049、0098、0099):由 iceberg 0.6 传递树中的旧版依赖引入,主 TLS 链路已全部使用修复后的 rustls-webpki 0.103.12。